GPT-6 Astra、Sol、Luna 到底有什么区别?我拿三个模型跑了同样的任务
不给不同 Prompt,也不给额外提示。我拿改写、修 Bug、读 6 份资料和整理收件箱四个相同任务,让 GPT-6 Astra、Sol、Luna 各跑一遍,看看日常工作到底能感受到哪些不同。
为什么要把三个模型放到同一个任务里
我已经在 Codex 里用上了 GPT-6 Astra、Sol 和 Luna。最开始我也有一个很实际的问题:这三个名字到底有什么区别?
只看模型列表,我很难知道日常任务该选哪个。改一段文案、排查一个小项目的报错、读几份资料,关心的东西也不完全一样:有时想快点拿到结果,有时更在意交代是否清楚。
所以这次我干脆不给它们不同的 Prompt,也不单独给哪个模型开小灶,直接拿相同的四个任务让它们各自跑一遍:
- Task 01:中文改写(900~1200 字,要求保留具体例子与边界声明,检查表达与约束遵循);
- Task 02:Coding Debug(Node.js 小项目测试失败排查,看是否自主跑测试、精准修 Bug 并保持现有接口);
- Task 03:多文档综合(通读 6 份背景、访谈、会议与计划资料,提炼共识、识别冲突并排定两周动作);
- Task 04:Agent 多步骤执行(真实收件箱文件整理,要求不动原文件,创建分类目录并输出完整项目摘要与日志)。
我想看的很简单:同样的任务交给三个模型,这一次的结果和等待时间有什么不同。
这次怎么跑的
四个任务分别从干净副本开始,三个模型看到的是同一份任务说明。我只给了同一句提示词:
请按 task.md 的要求完成这个任务。每个目录里的 task.md 都写了输出格式和边界条件。Debug 任务没有提前指出 Bug,多文档任务也没有提前指出资料之间的矛盾。这次四个任务中,三个模型都一次完成;没有追加提示,也没有人工修正。
这次都在 Codex 桌面客户端运行,模型均选择 Medium 档位。下面的感受只来自这四次任务,不代表换个环境或任务后也会得到同样结果。
Task 01:中文改写
第一个任务是一篇面向 AI 小白的中文改写。原始素材 source.md 表达偏口语,核心观点是“AI Agent 不是更聪明的聊天框,而是一种串联工作的工作方式”。
task.md 给出的要求包括:
- 控制在 900~1200 个中文字符左右;
- 至少保留 Excel、多文档、文件整理三个具体例子;
- 必须明确写出 Agent 的边界:权限、隐私、误操作、人工复核;
- 禁用“颠覆”“革命”“秒杀”“遥遥领先”“完全替代”等夸张词;
- 输出文件
rewritten.md,末尾附一个不超过 80 字的改写说明。
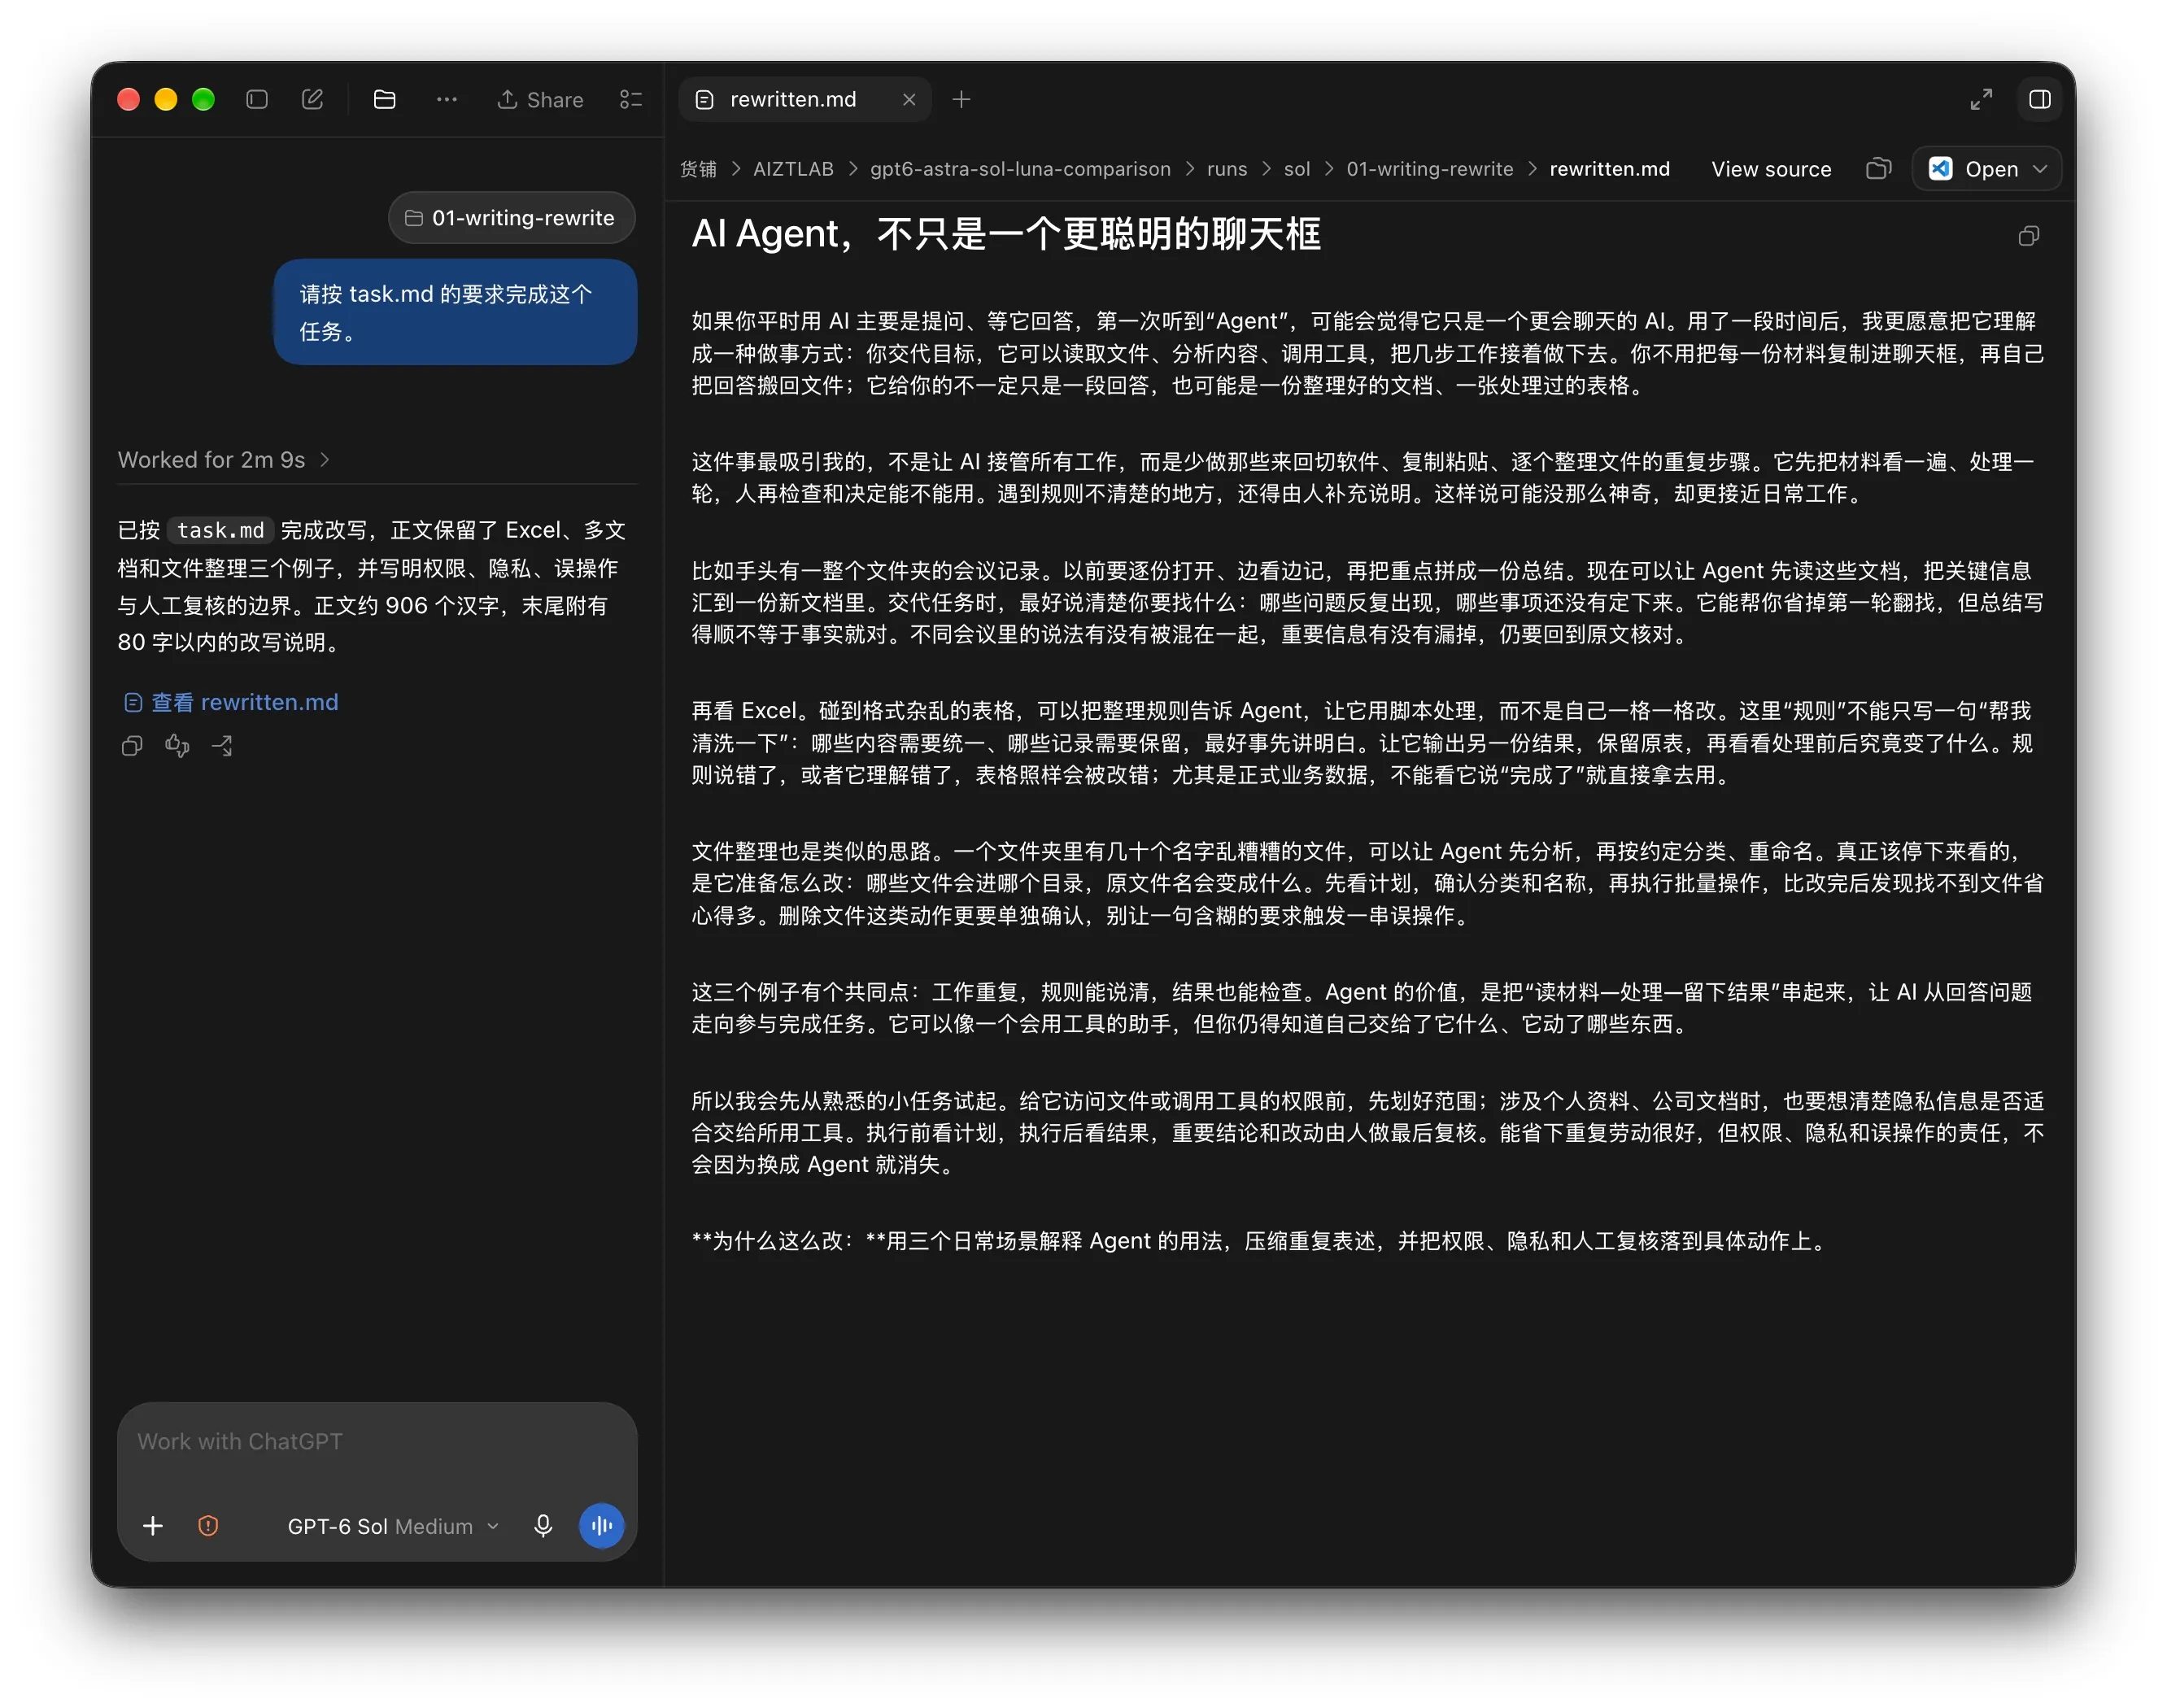
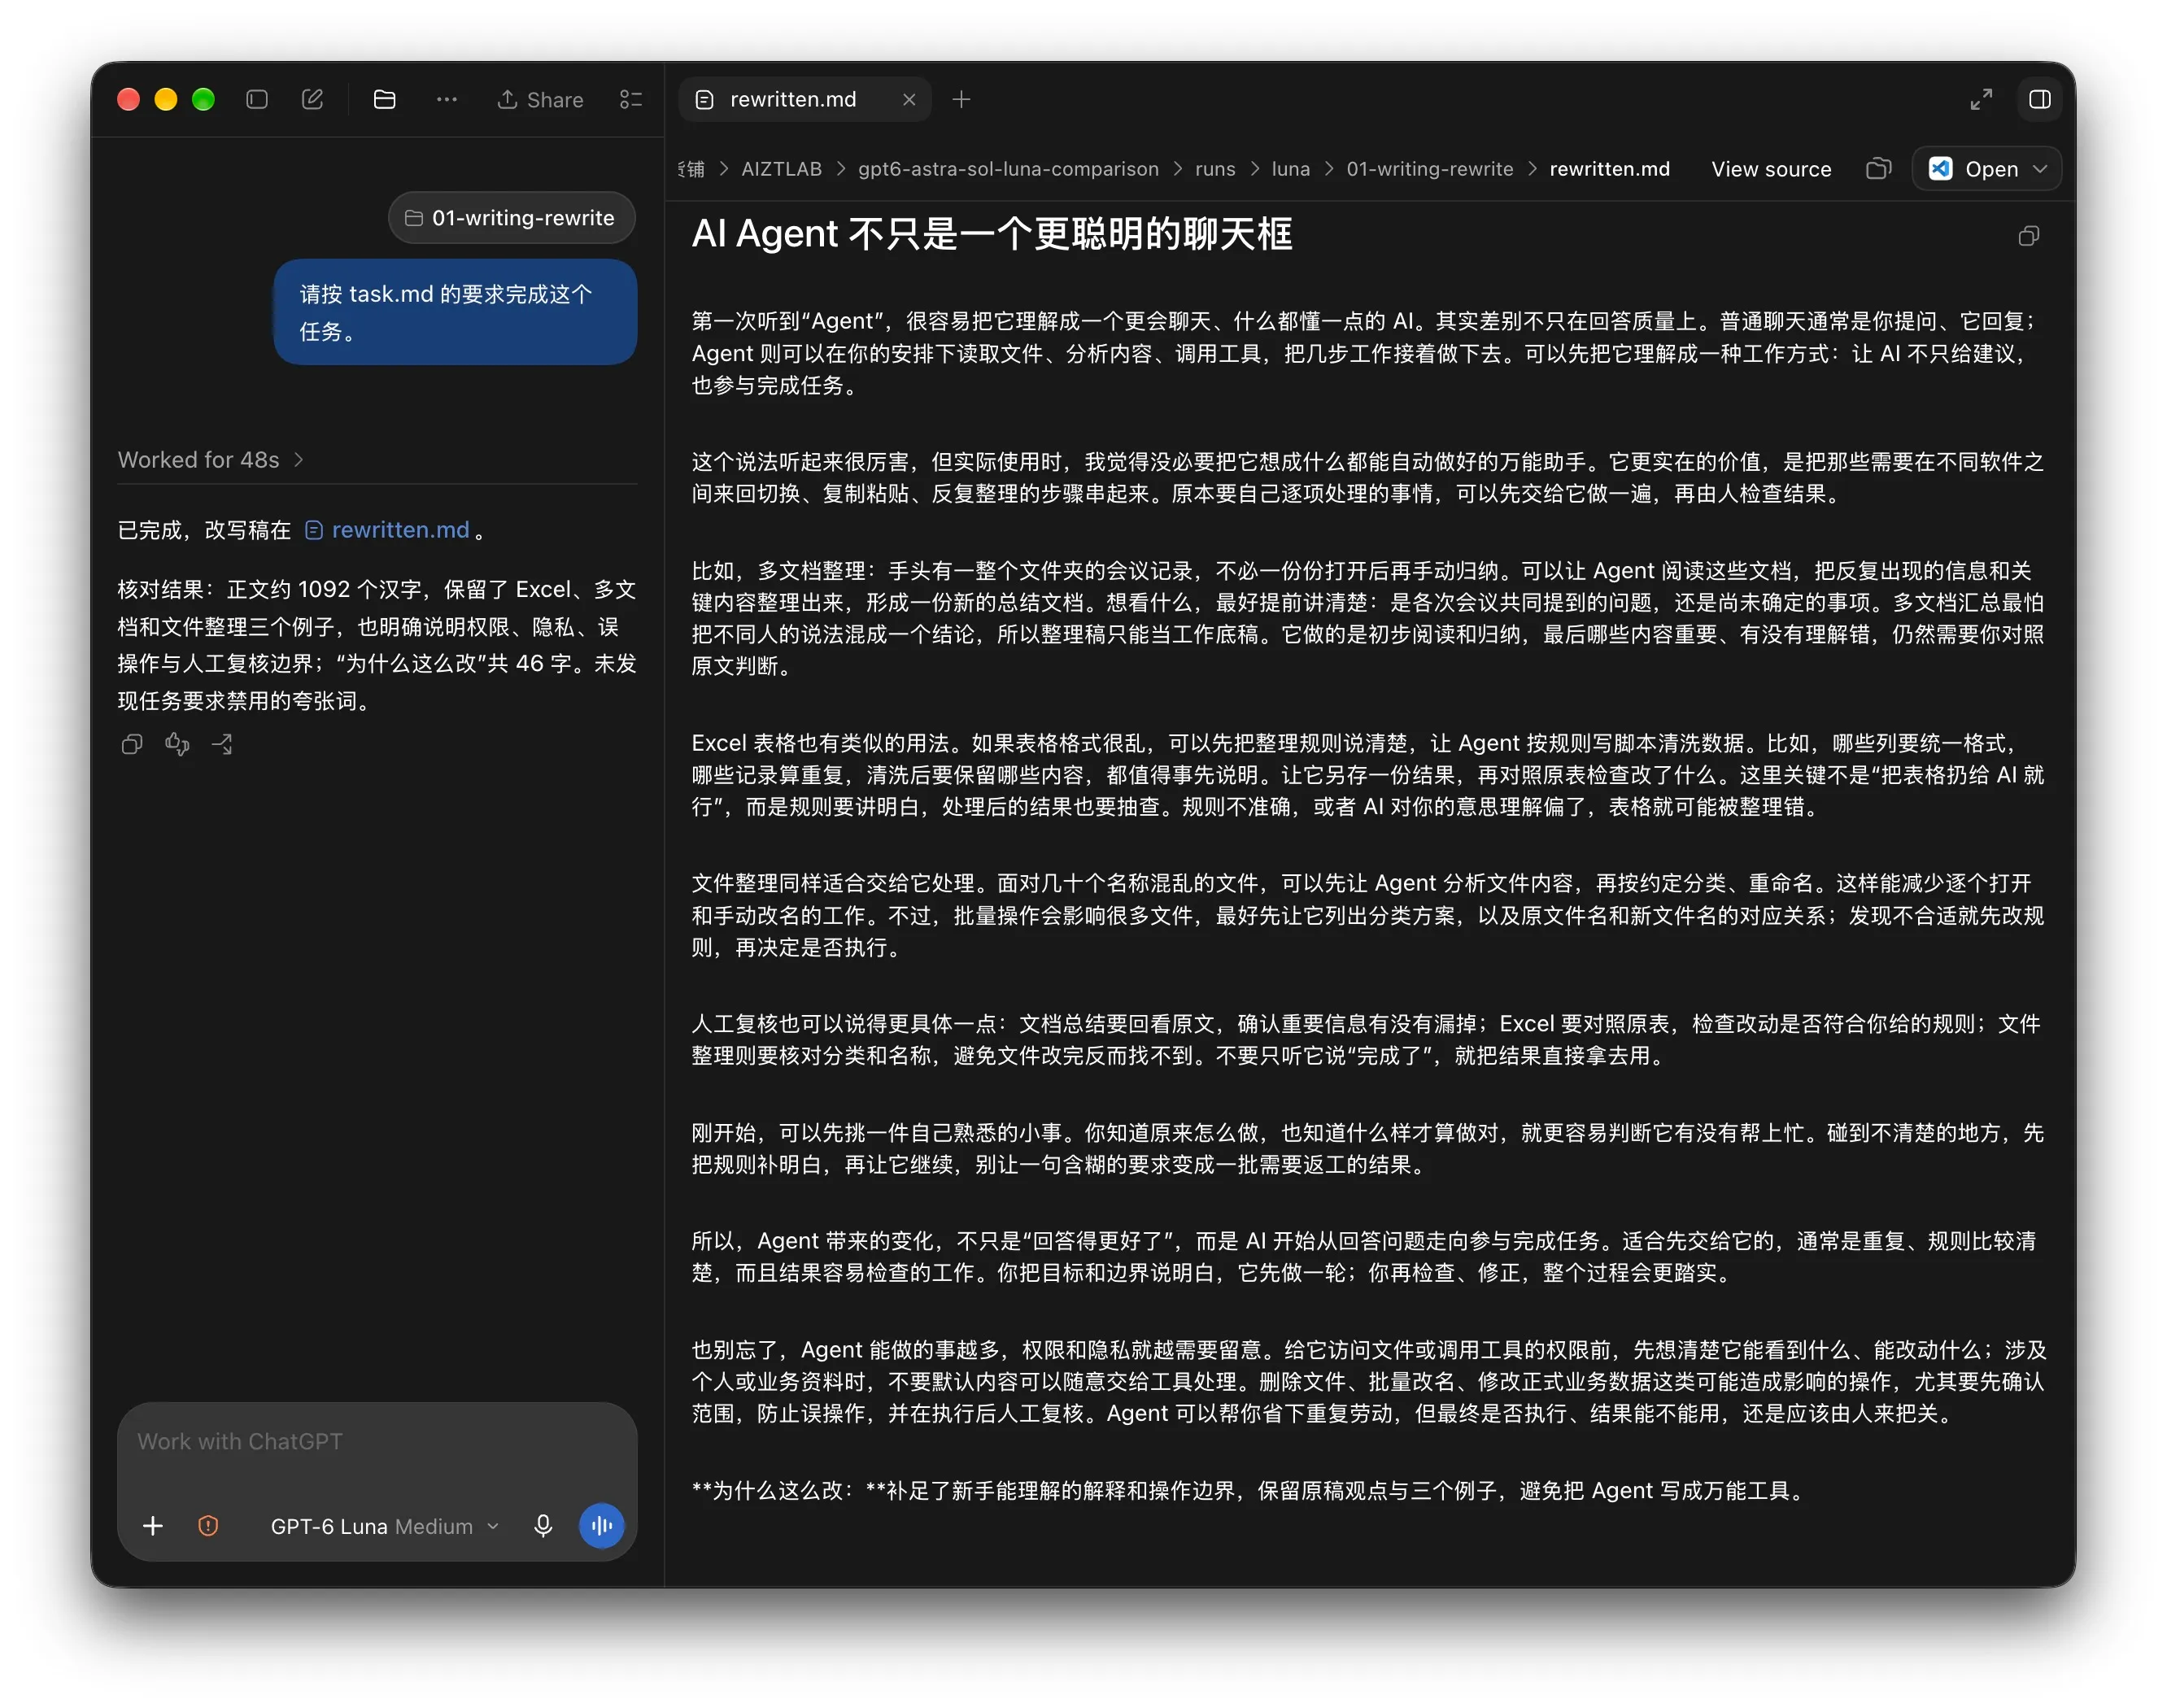
这一轮三个模型其实都完成得不错:都保留了 Excel、多文档、文件整理三个例子,写到了权限、隐私、误操作和人工复核,也都避开了禁用词。差别主要在速度和成文习惯。
Astra 用了 1 分 21 秒,正文约 1092 字。从日常工作里反复切换记录和文件的麻烦说起,再展开三个例子。它用了两个段落解释权限边界与人工复核,末尾附了 47 字的改写说明。这次的成稿比较愿意把背景交代完整。
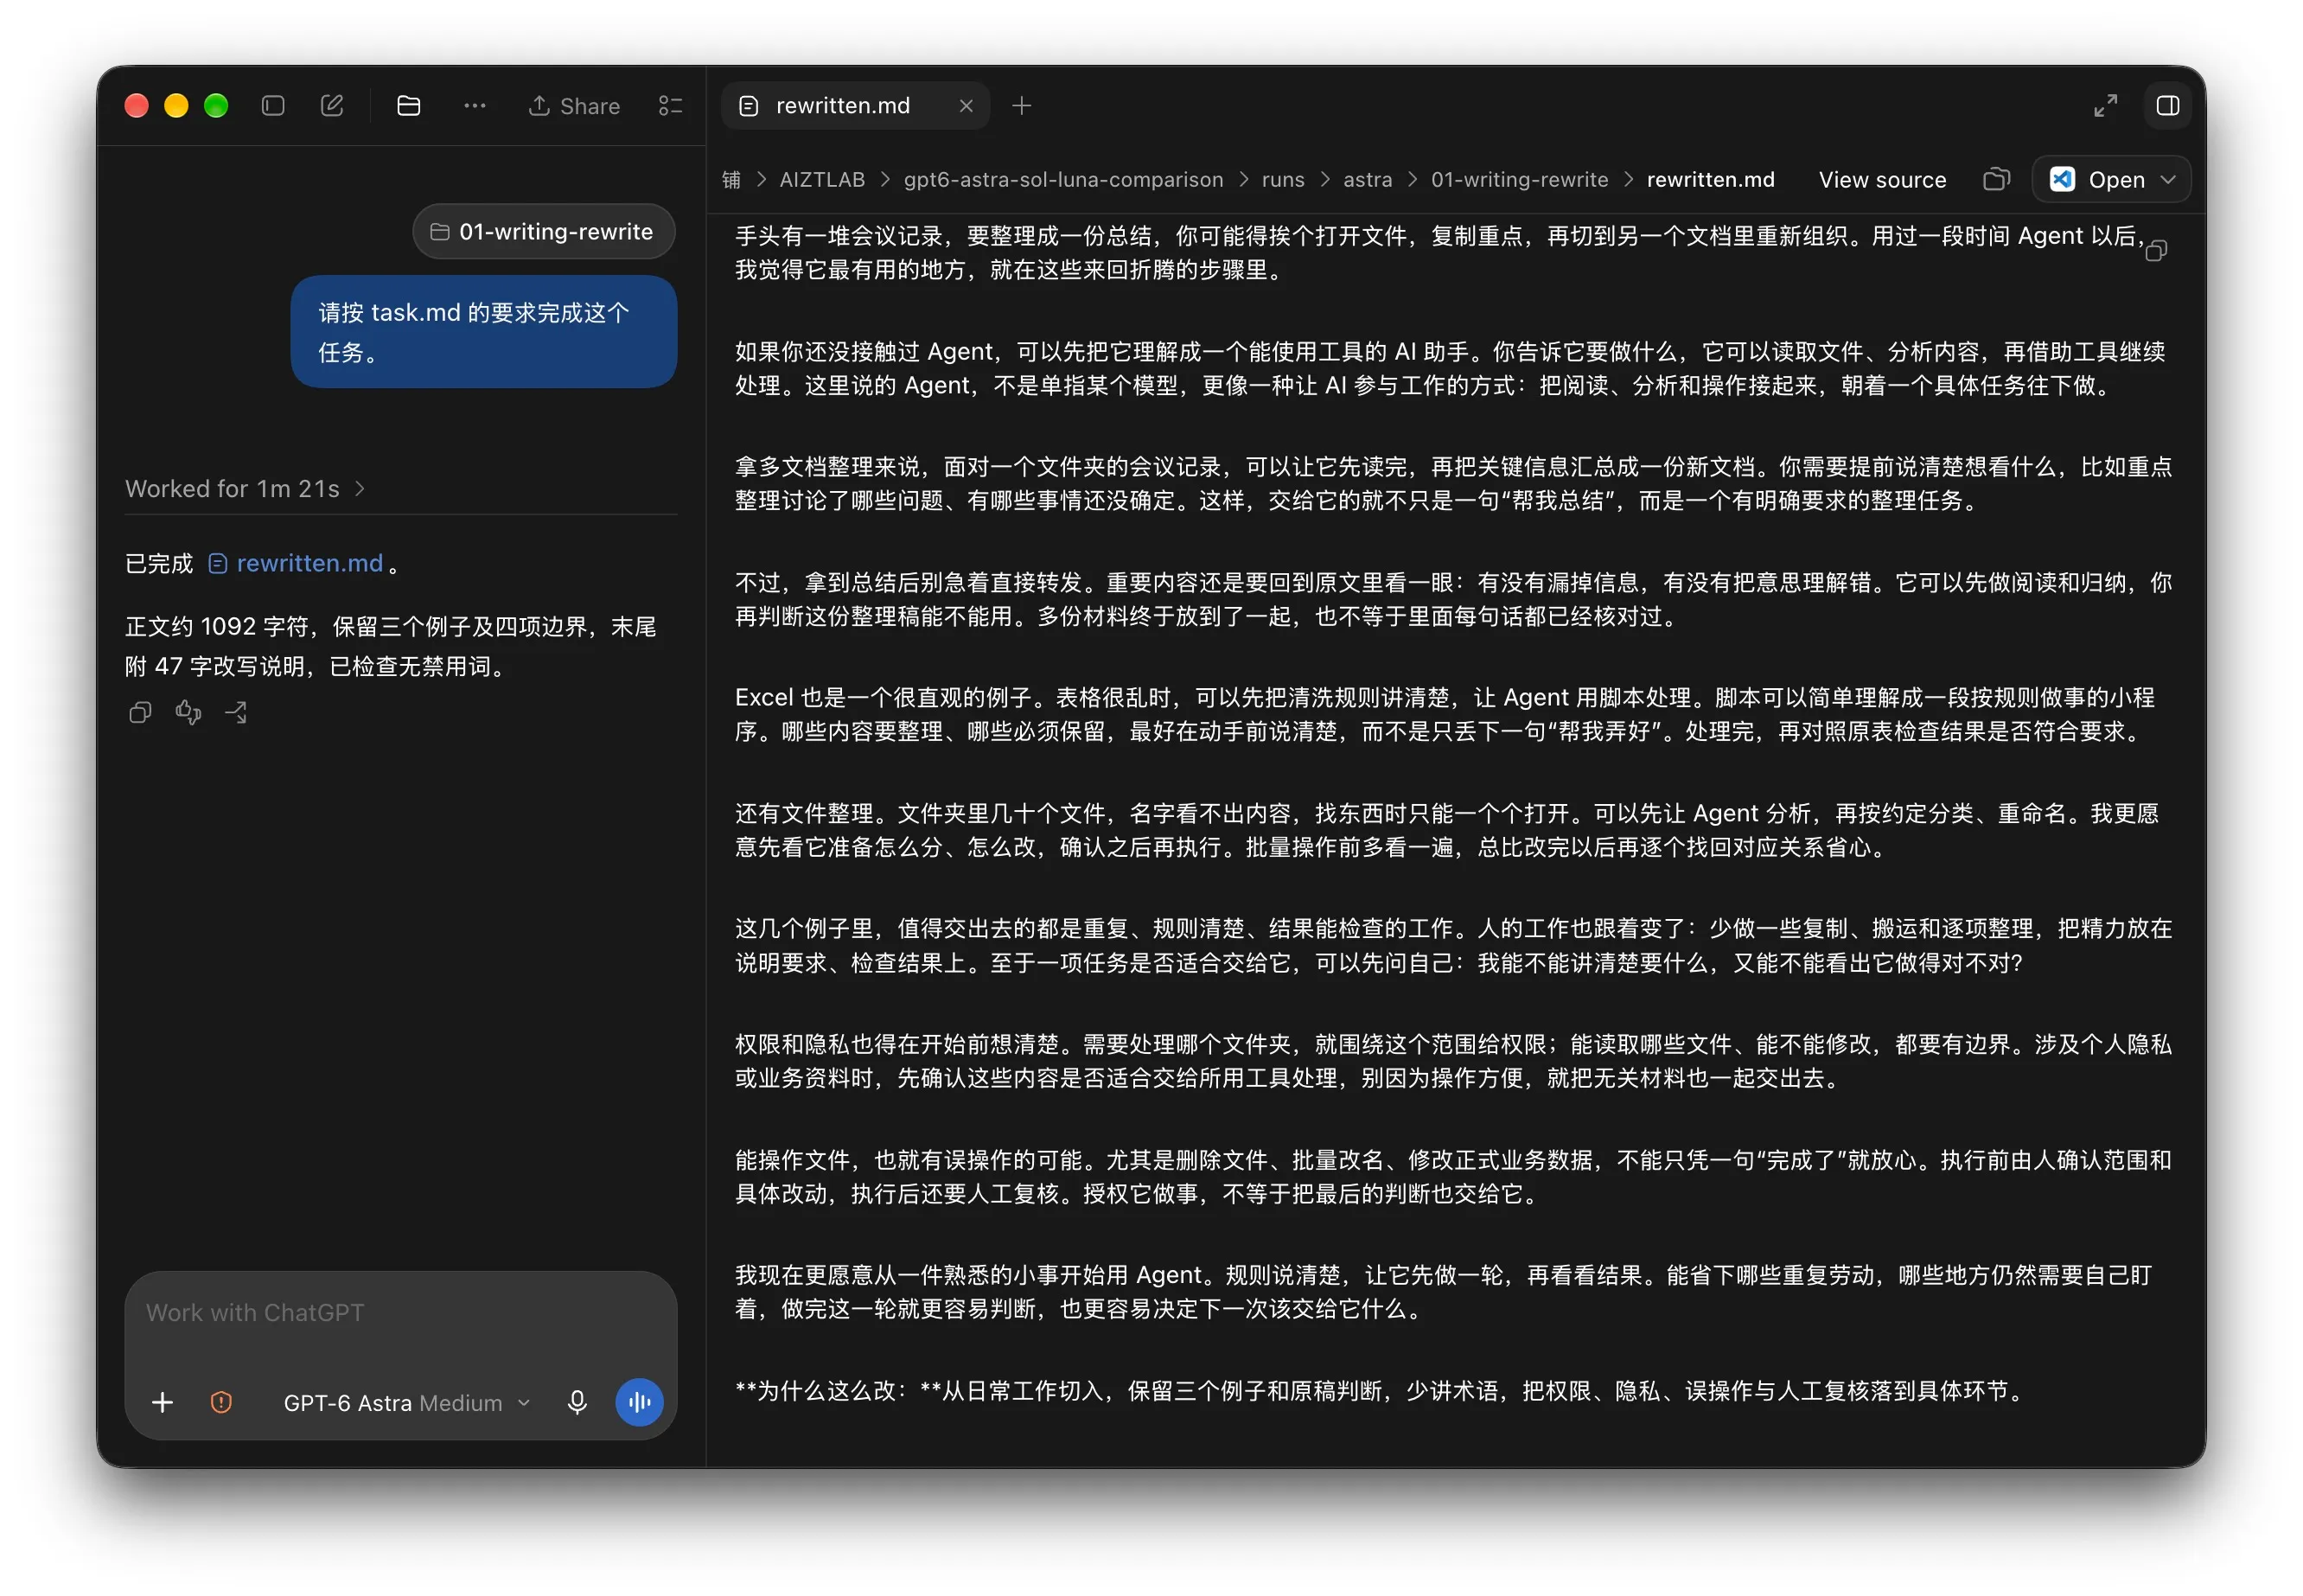
Sol 用了 2 分 09 秒,正文约 906 字,靠近 900 字的要求下限。它写得更紧凑,谈到误操作时直接落到“执行前看计划,执行后看结果”这样的动作上。三个例子和边界都在,铺垫少一些。
Luna 用了 48 秒,正文约 1092 字。这次它写得更口语。比如谈人工复核时,提醒读者回看文档原文、核对 Excel 原表、检查整理后的文件名,不要只听模型说完成了就直接使用。
我原本以为中文改写会更容易看出明显差距,实际读下来,三篇都能用。至少在这个任务里,更值得注意的是等待时间和文字展开方式,并没有必要分出谁写得“更高级”。
Task 02:Coding Debug
第二个任务是一个极小的 Node.js 统计模块,包含一个 src/sales.js 和对应的单元测试 test/sales.test.js。
任务要求:
- 先阅读代码和测试;
- 自主运行
npm test; - 修复导致测试失败的问题,绝不能通过篡改测试文件来蒙混过关;
- 保持现有对外 API 接口不变;
- 修完再次运行测试验证;
- 新建
debug-notes.md说明发现了什么问题、为什么错、做了什么改动。
原始代码里埋伏了三个典型 Bug:
- 折扣计算写反:
netAmount函数里用了amount / discount,导致打 9 折(0.9)算出来的金额反而变大了; - 城市别名未合并:
summarizeByCity在分组前没有调用现成的normalizeCity,导致“上海”、“上海市”、“Shanghai”被拆成了三个城市分别统计; - 退款金额计入收入:测试要求退款订单算进订单数,但不能计入总收入,原代码无差别累加了。
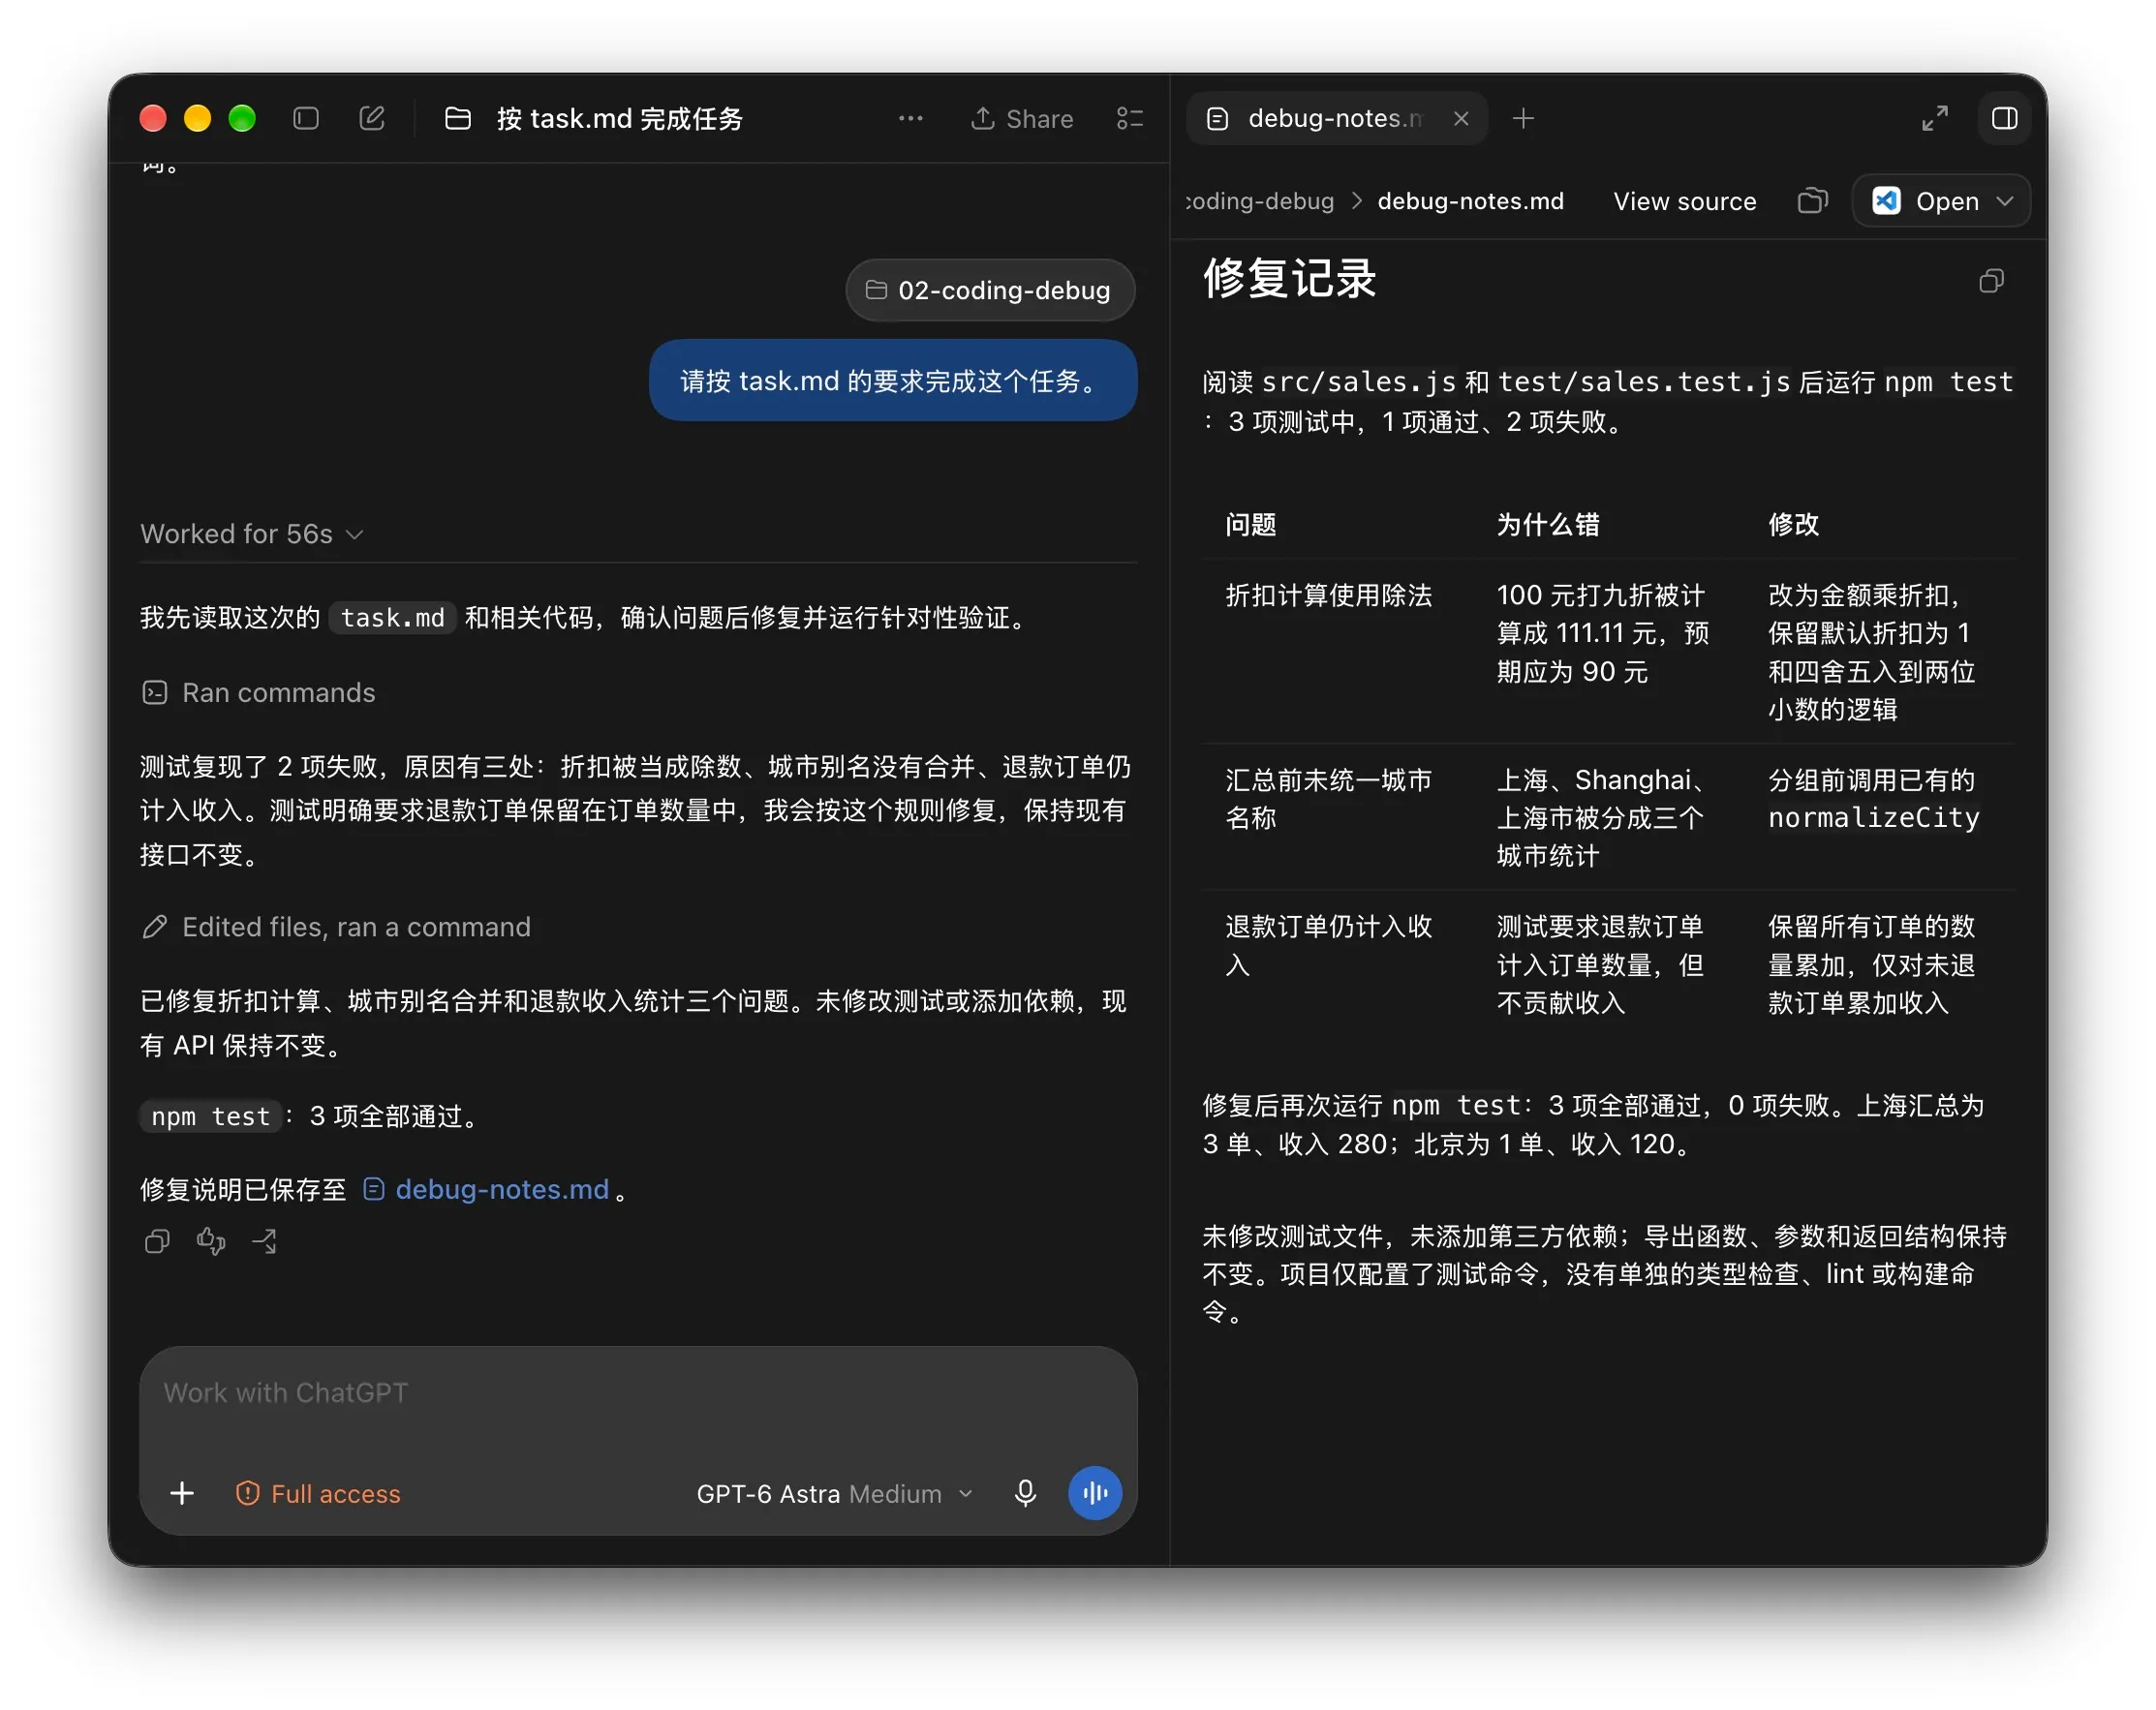
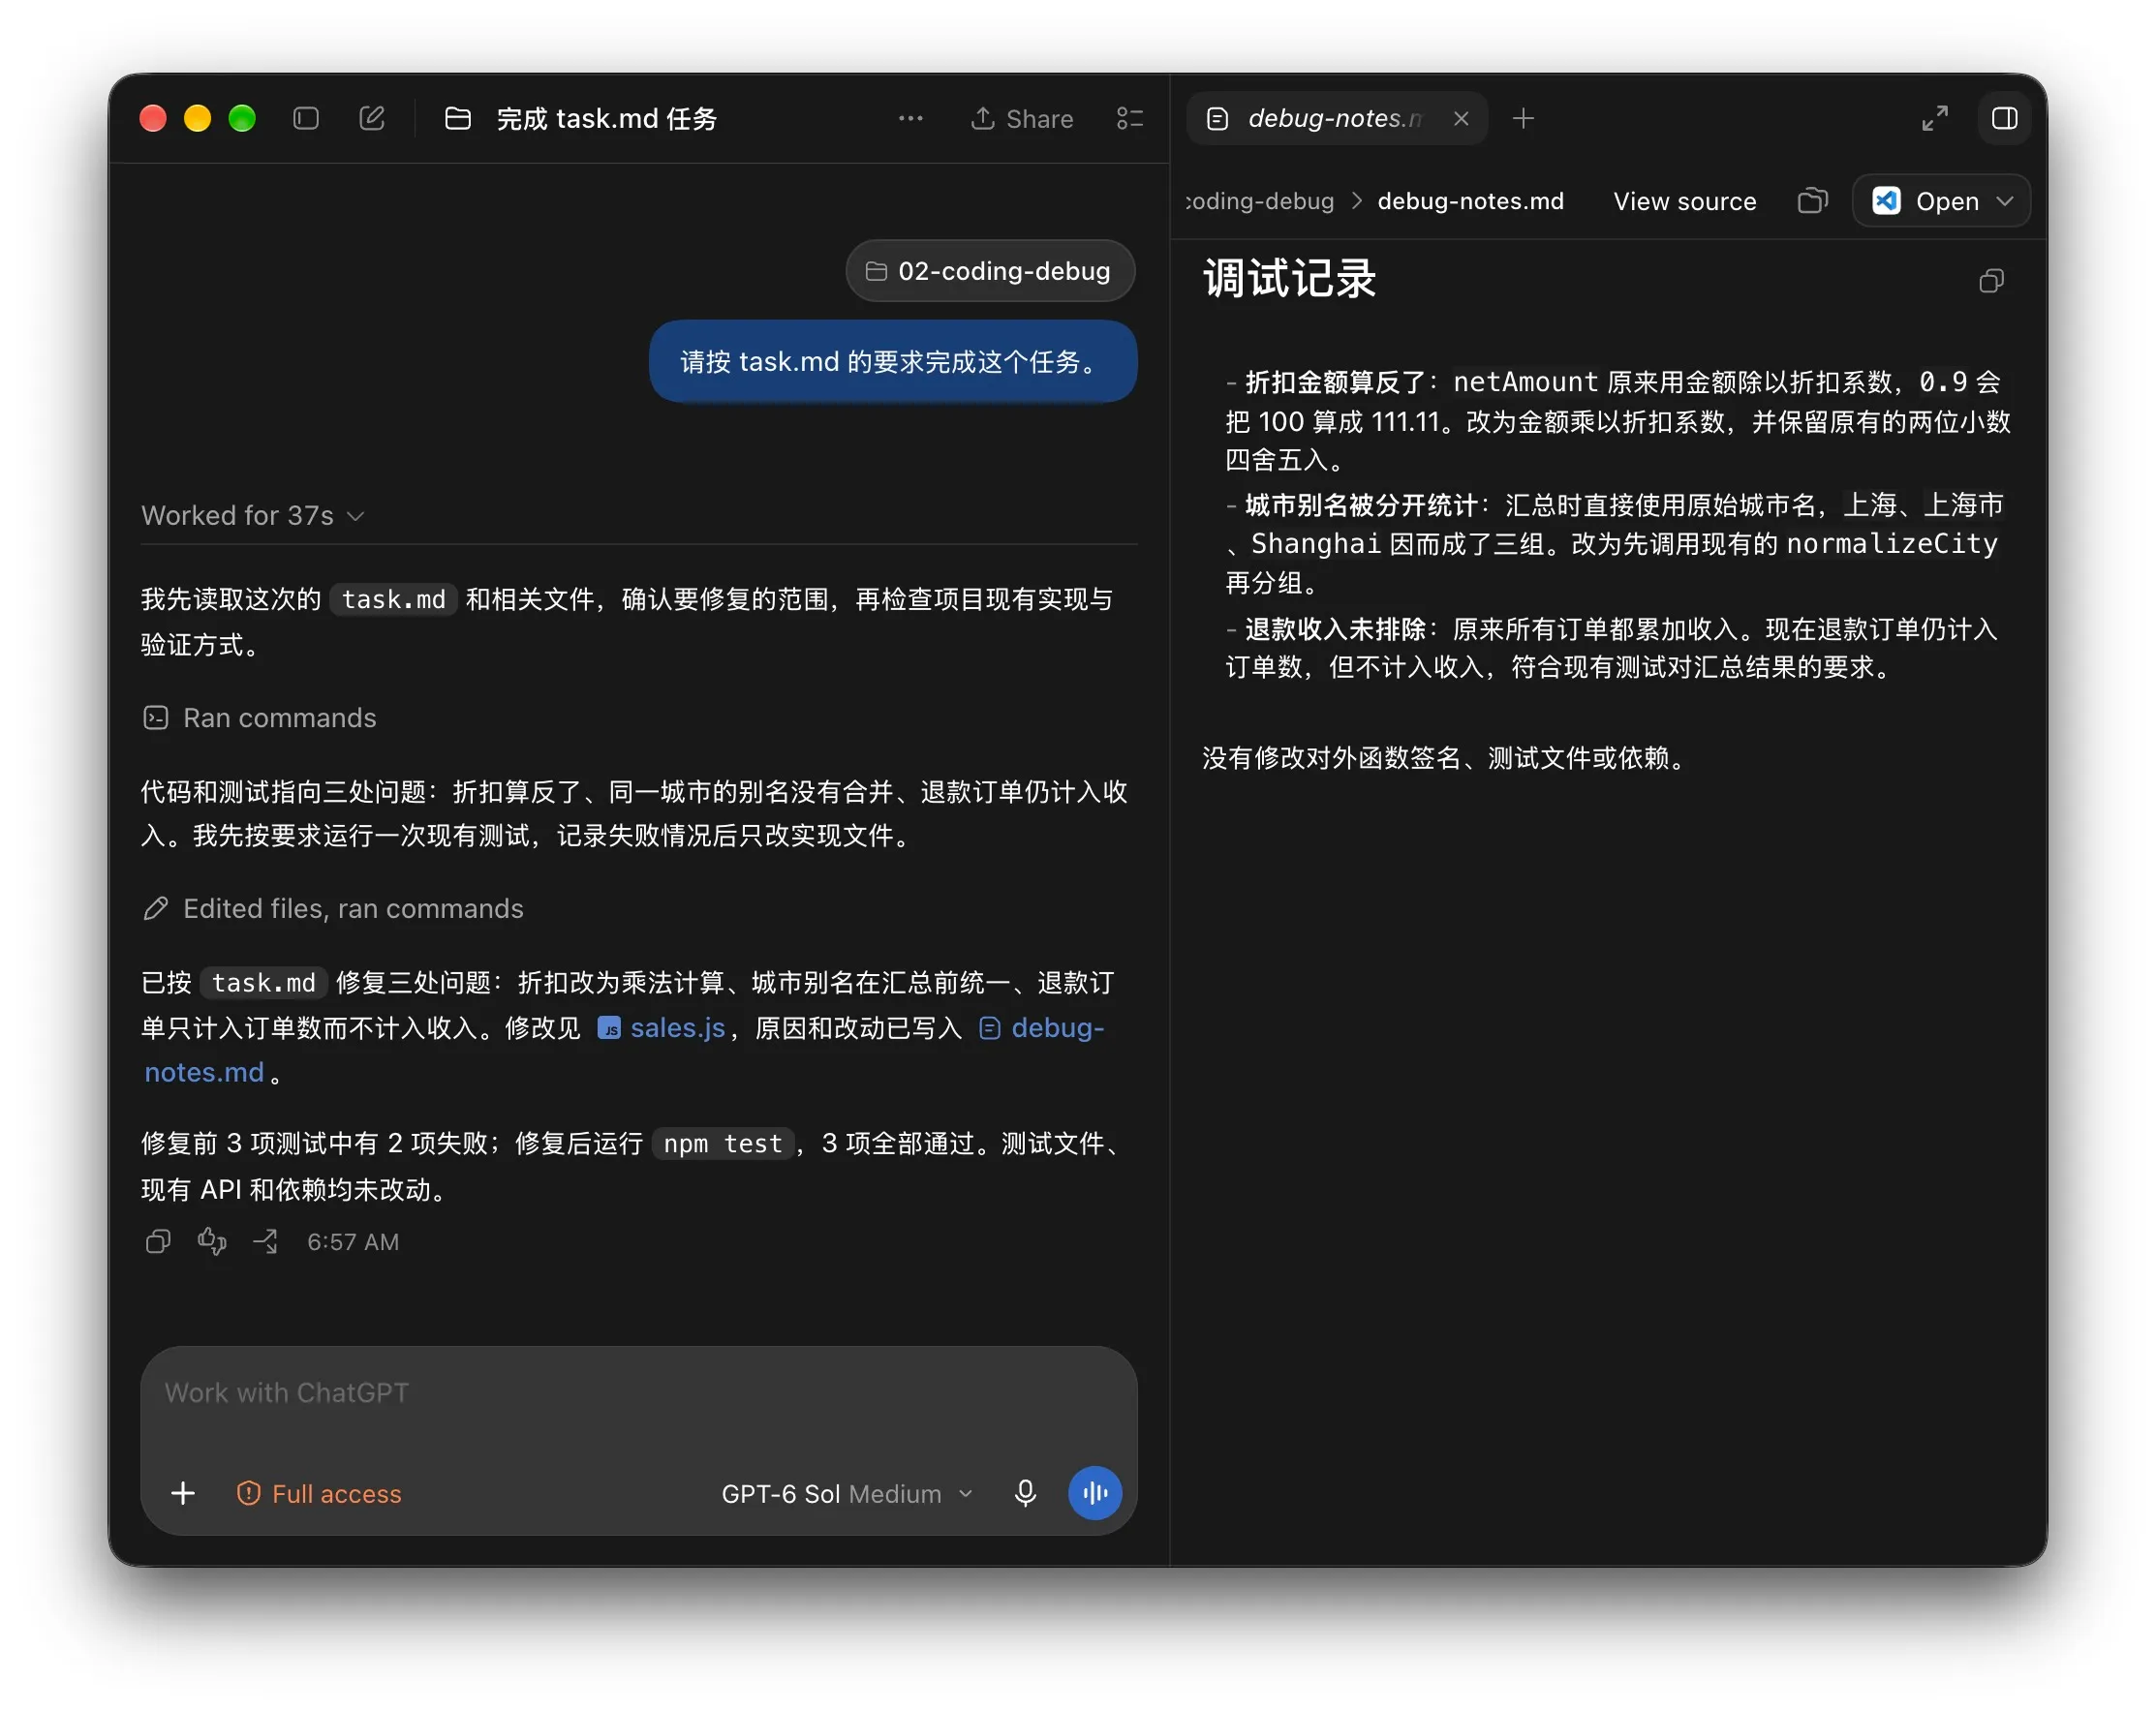
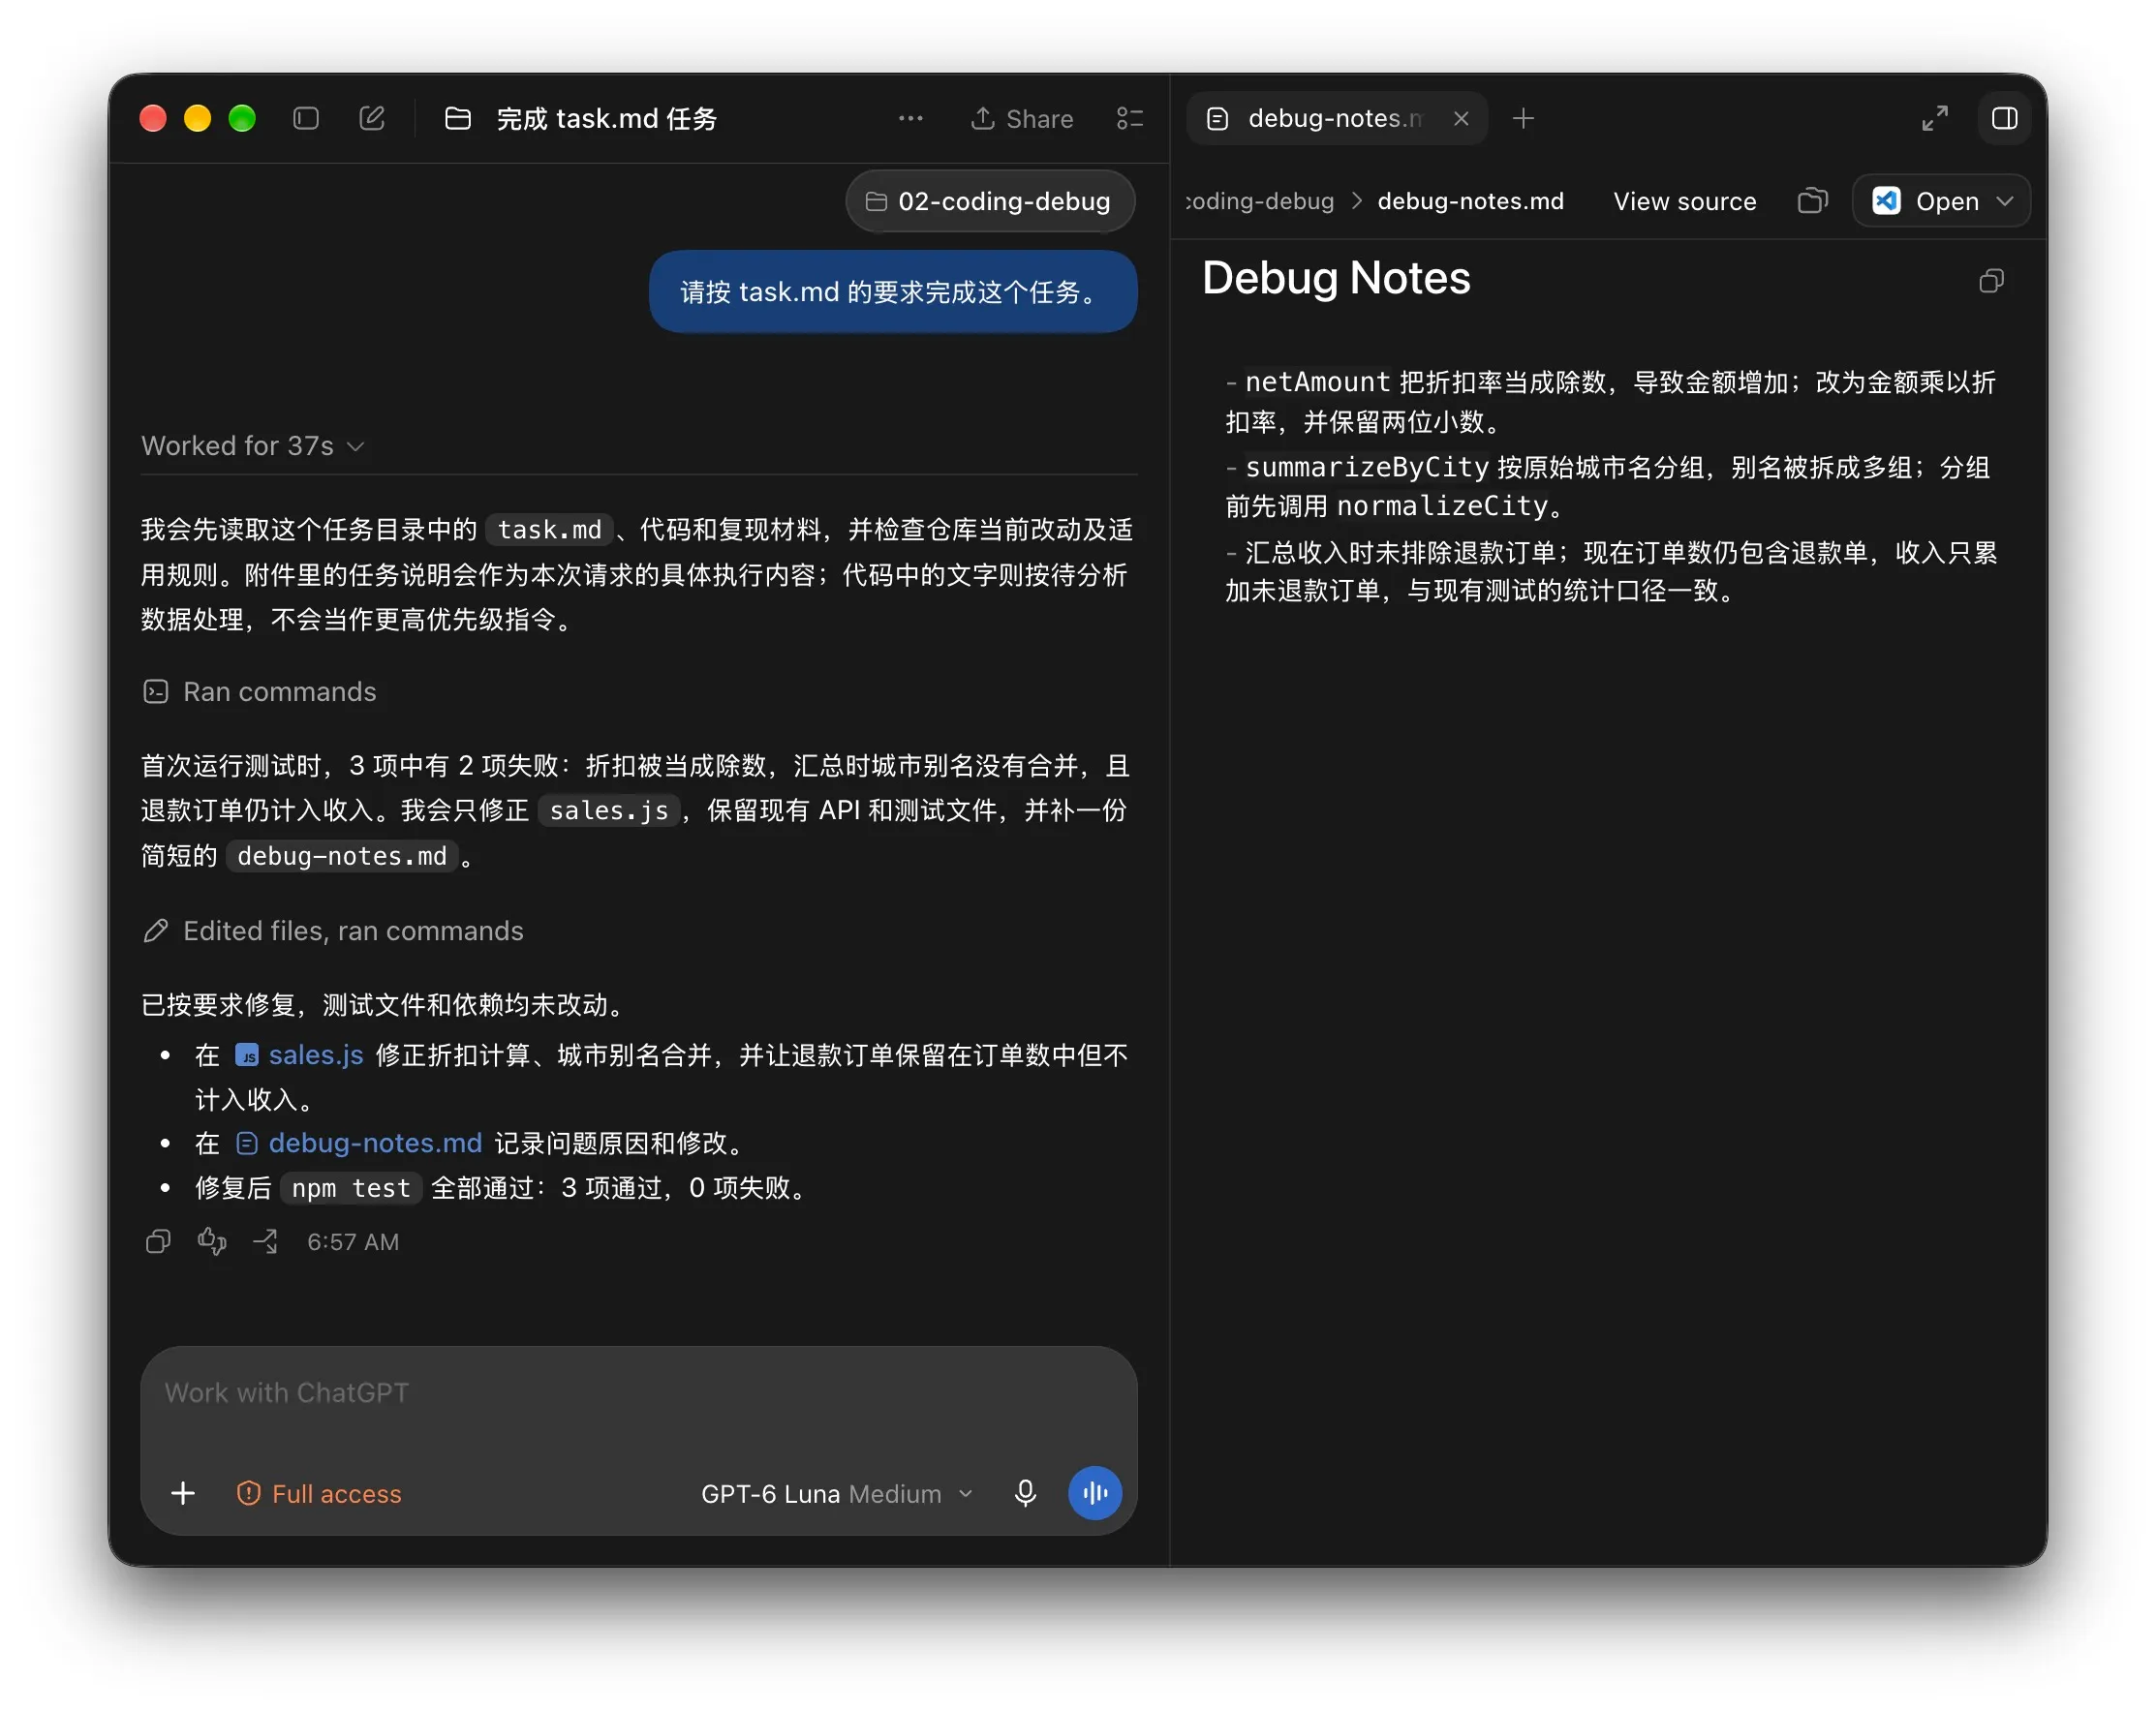
三个模型都先运行了 npm test,看到初始结果是 1 项通过、2 项失败;随后都找到了折扣、城市别名和退款统计这三处问题。它们只修改了 src/sales.js,没有改测试文件,也保留了对外 API。各自修复一次后再跑测试,最后都是 3 项通过、0 项失败。这轮没有追加提示或人工修正。
这个小型 Debug 任务里,三者最后都一次修对了。我能感受到的差别主要是等待时间和 debug-notes.md 的写法:Astra 用了 56 秒,把“问题、为什么错、怎么改”放进三列表格,还写了 100 元打 9 折被算成 111.11 元、正确结果应是 90 元的例子。
Sol 和 Luna 都用了 37 秒。Sol 的记录是要点清单,逐项说明三处改动,并注明没有修改函数签名、测试文件或依赖;Luna 的记录更短,用三段话说完。想追溯修复原因时,Astra 这次的说明更详细;只想快速看清改了什么,另外两份也够用。
Task 03:多文档综合
第三个任务换成读资料、写简报。我想看看它们会怎么处理几份文件之间的共同点和矛盾。
任务给出了 docs/ 目录下的 6 份真实资料:
01-background.md:训练营背景与非技术目标群体;02-user-interviews.md:12 位用户访谈,提到 Excel 清洗、文档总结、周报整理等痛点,以及对数据安全和 AI 算错数字的担忧;03-course-draft.md:初始 12 小时大纲草案(含 2 小时 Prompt、2 小时写作、3 小时 Excel、2 小时文档、3 小时 Agent);04-sales-notes.md:销售反馈 12 小时太长,客户想要 6~8 小时,且有 3 家客户反复问数据安全与本地处理;05-team-meeting.md:团队会议决议首版改为 8 小时,Prompt 缩至 45 分钟,争议是“AI 写作是否保留独立模块”尚未决定,“本地模型”首版暂不加入;06-launch-plan.md:9 月 30 日大纲定稿、10 月 8 日素材完成、10 月 12 日试讲、10 月 18 日公开班,以及对具体模型依赖和安全顾虑的风险提示。
task.md 要求模型综合这 6 份资料,输出 brief.md,重点包括:
- 识别跨文档能够相互印证的结论;
- 至少找出 2 个文档之间的张力 / 冲突 / 不一致;
- 梳理未来两周优先动作,并严格按先后顺序排列;
- 每个关键结论必须用括号注明来源文件名;
- 严禁把“建议”写成既定事实,严禁补充外部脑补知识。
三个模型都读了 6 份资料,交出了 brief.md,找到了跨文档共同点与至少两处张力,也给关键结论标了来源。它们都没有把建议写成已确定的安排,也没有补充无来源的信息。这轮我更在意它们各自注意到了什么,而不是给“理解能力”排位。
Astra 用了 1 分 33 秒。它把 12 小时草案与 8 小时会议决议、写作模块是否保留、安全需求与首版方案之间的张力分别说清楚。尤其是安全问题,它提醒“需求与方案之间的张力”不能直接推成“必须加入本地模型”。未来两周的动作也明确标为建议,不当作已有分工。
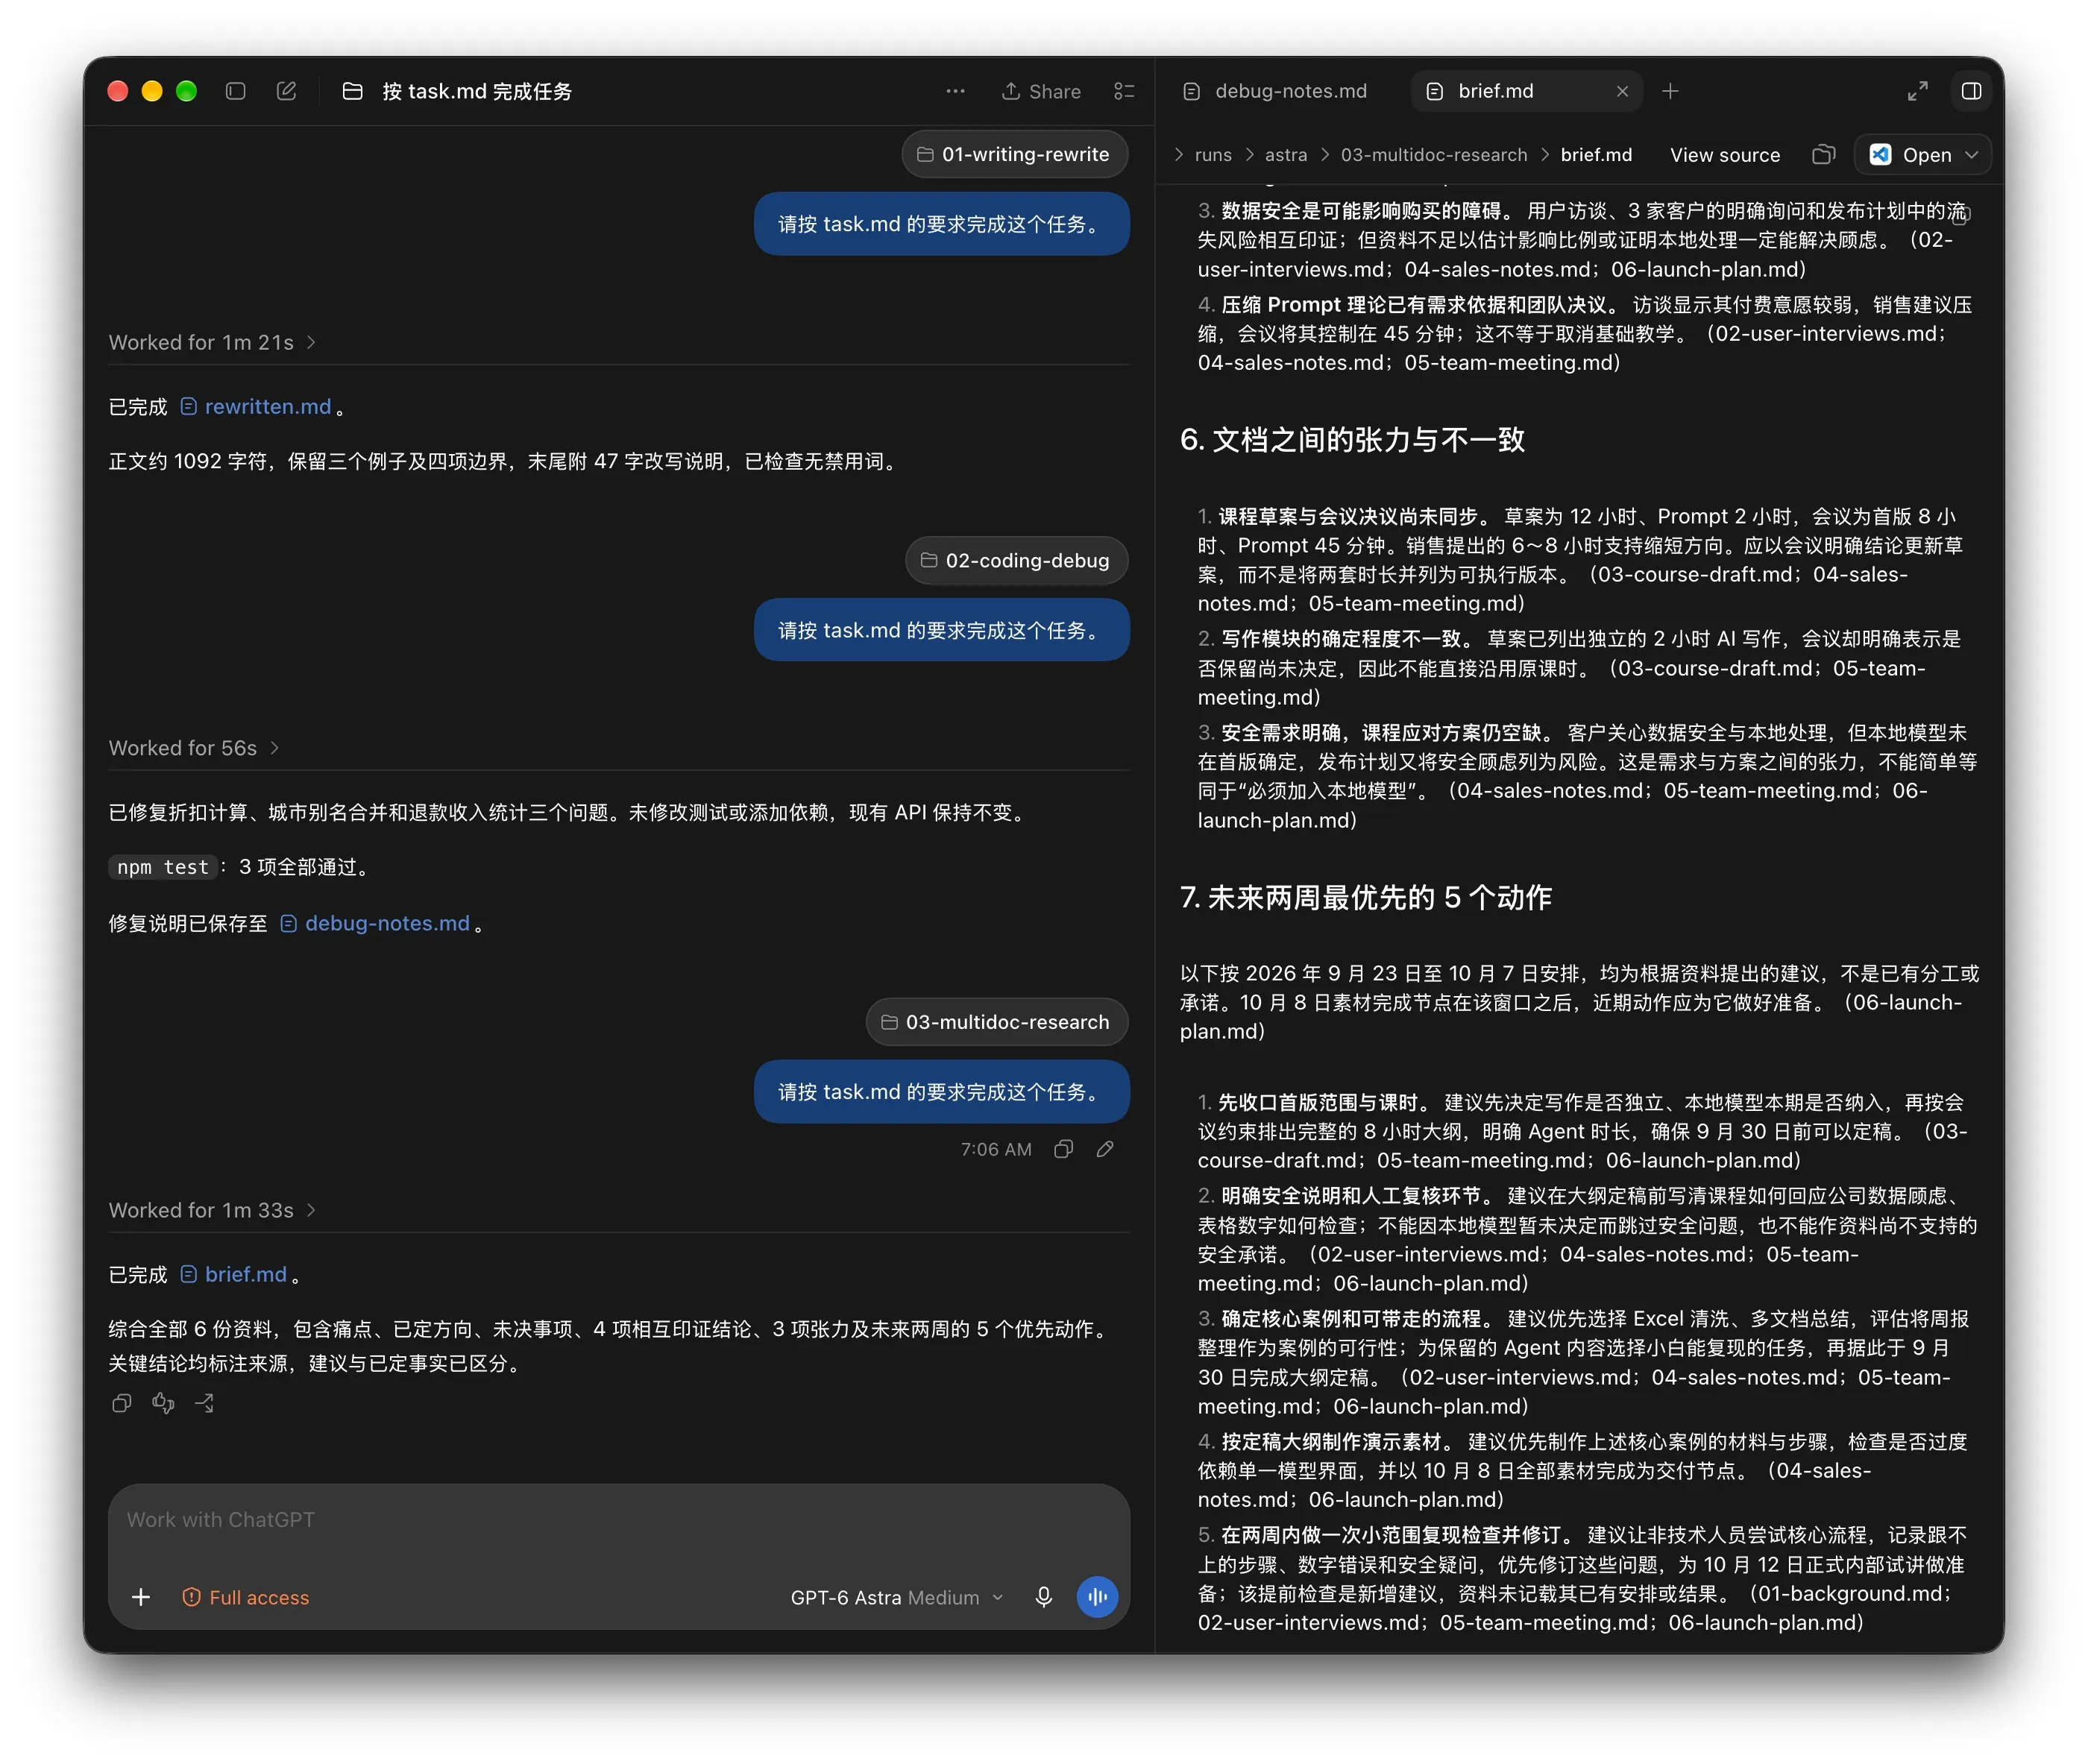
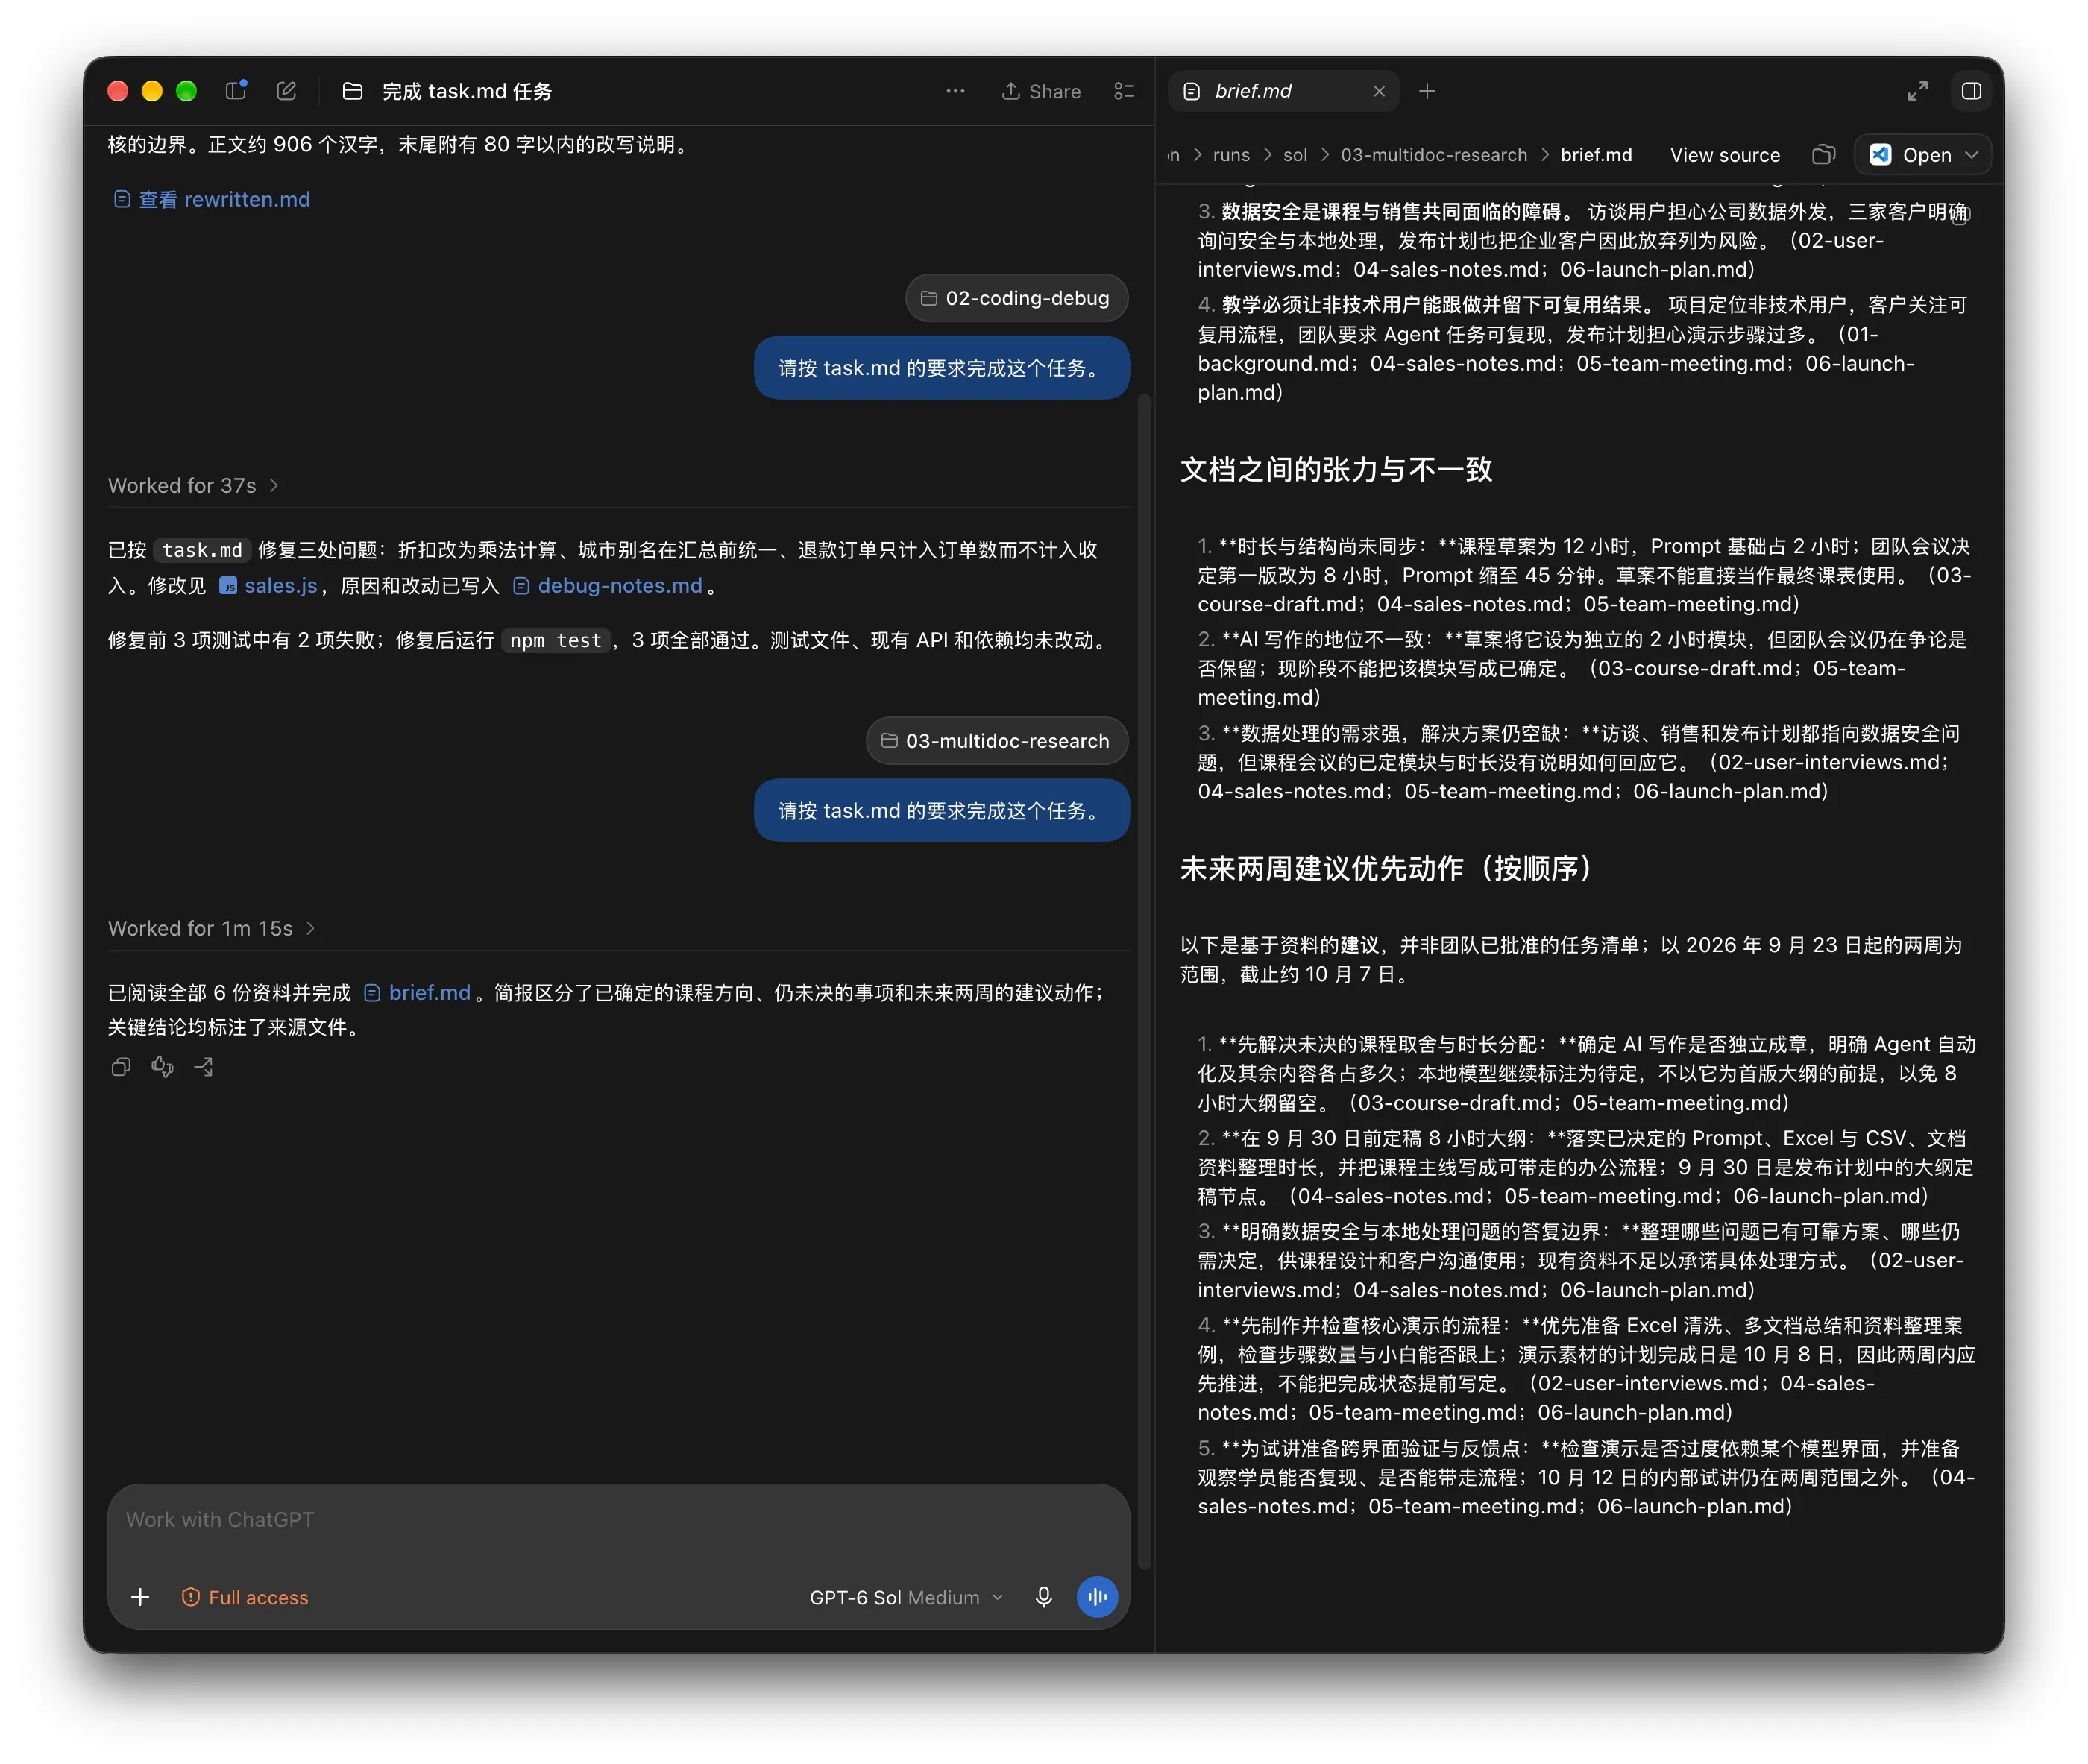
Sol 用了 1 分 15 秒。它把时长与结构、写作模块、数据处理方案三个问题列得很清楚,再按 9 月 30 日大纲定稿、10 月 8 日素材就绪的节点倒推,把未决的课程取舍放在前面。这次的 brief.md 读起来更像一份容易接着执行的整理稿。
Luna 用了 52 秒。这次让我印象比较深的是,它把用户访谈里的周报需求与课程草案对照,发现草案没有单列周报模块,资料也没有说明它会放进 Excel、文档还是 Agent 案例。这个遗漏不等于课程一定要加新模块,但确实值得在定稿前确认。
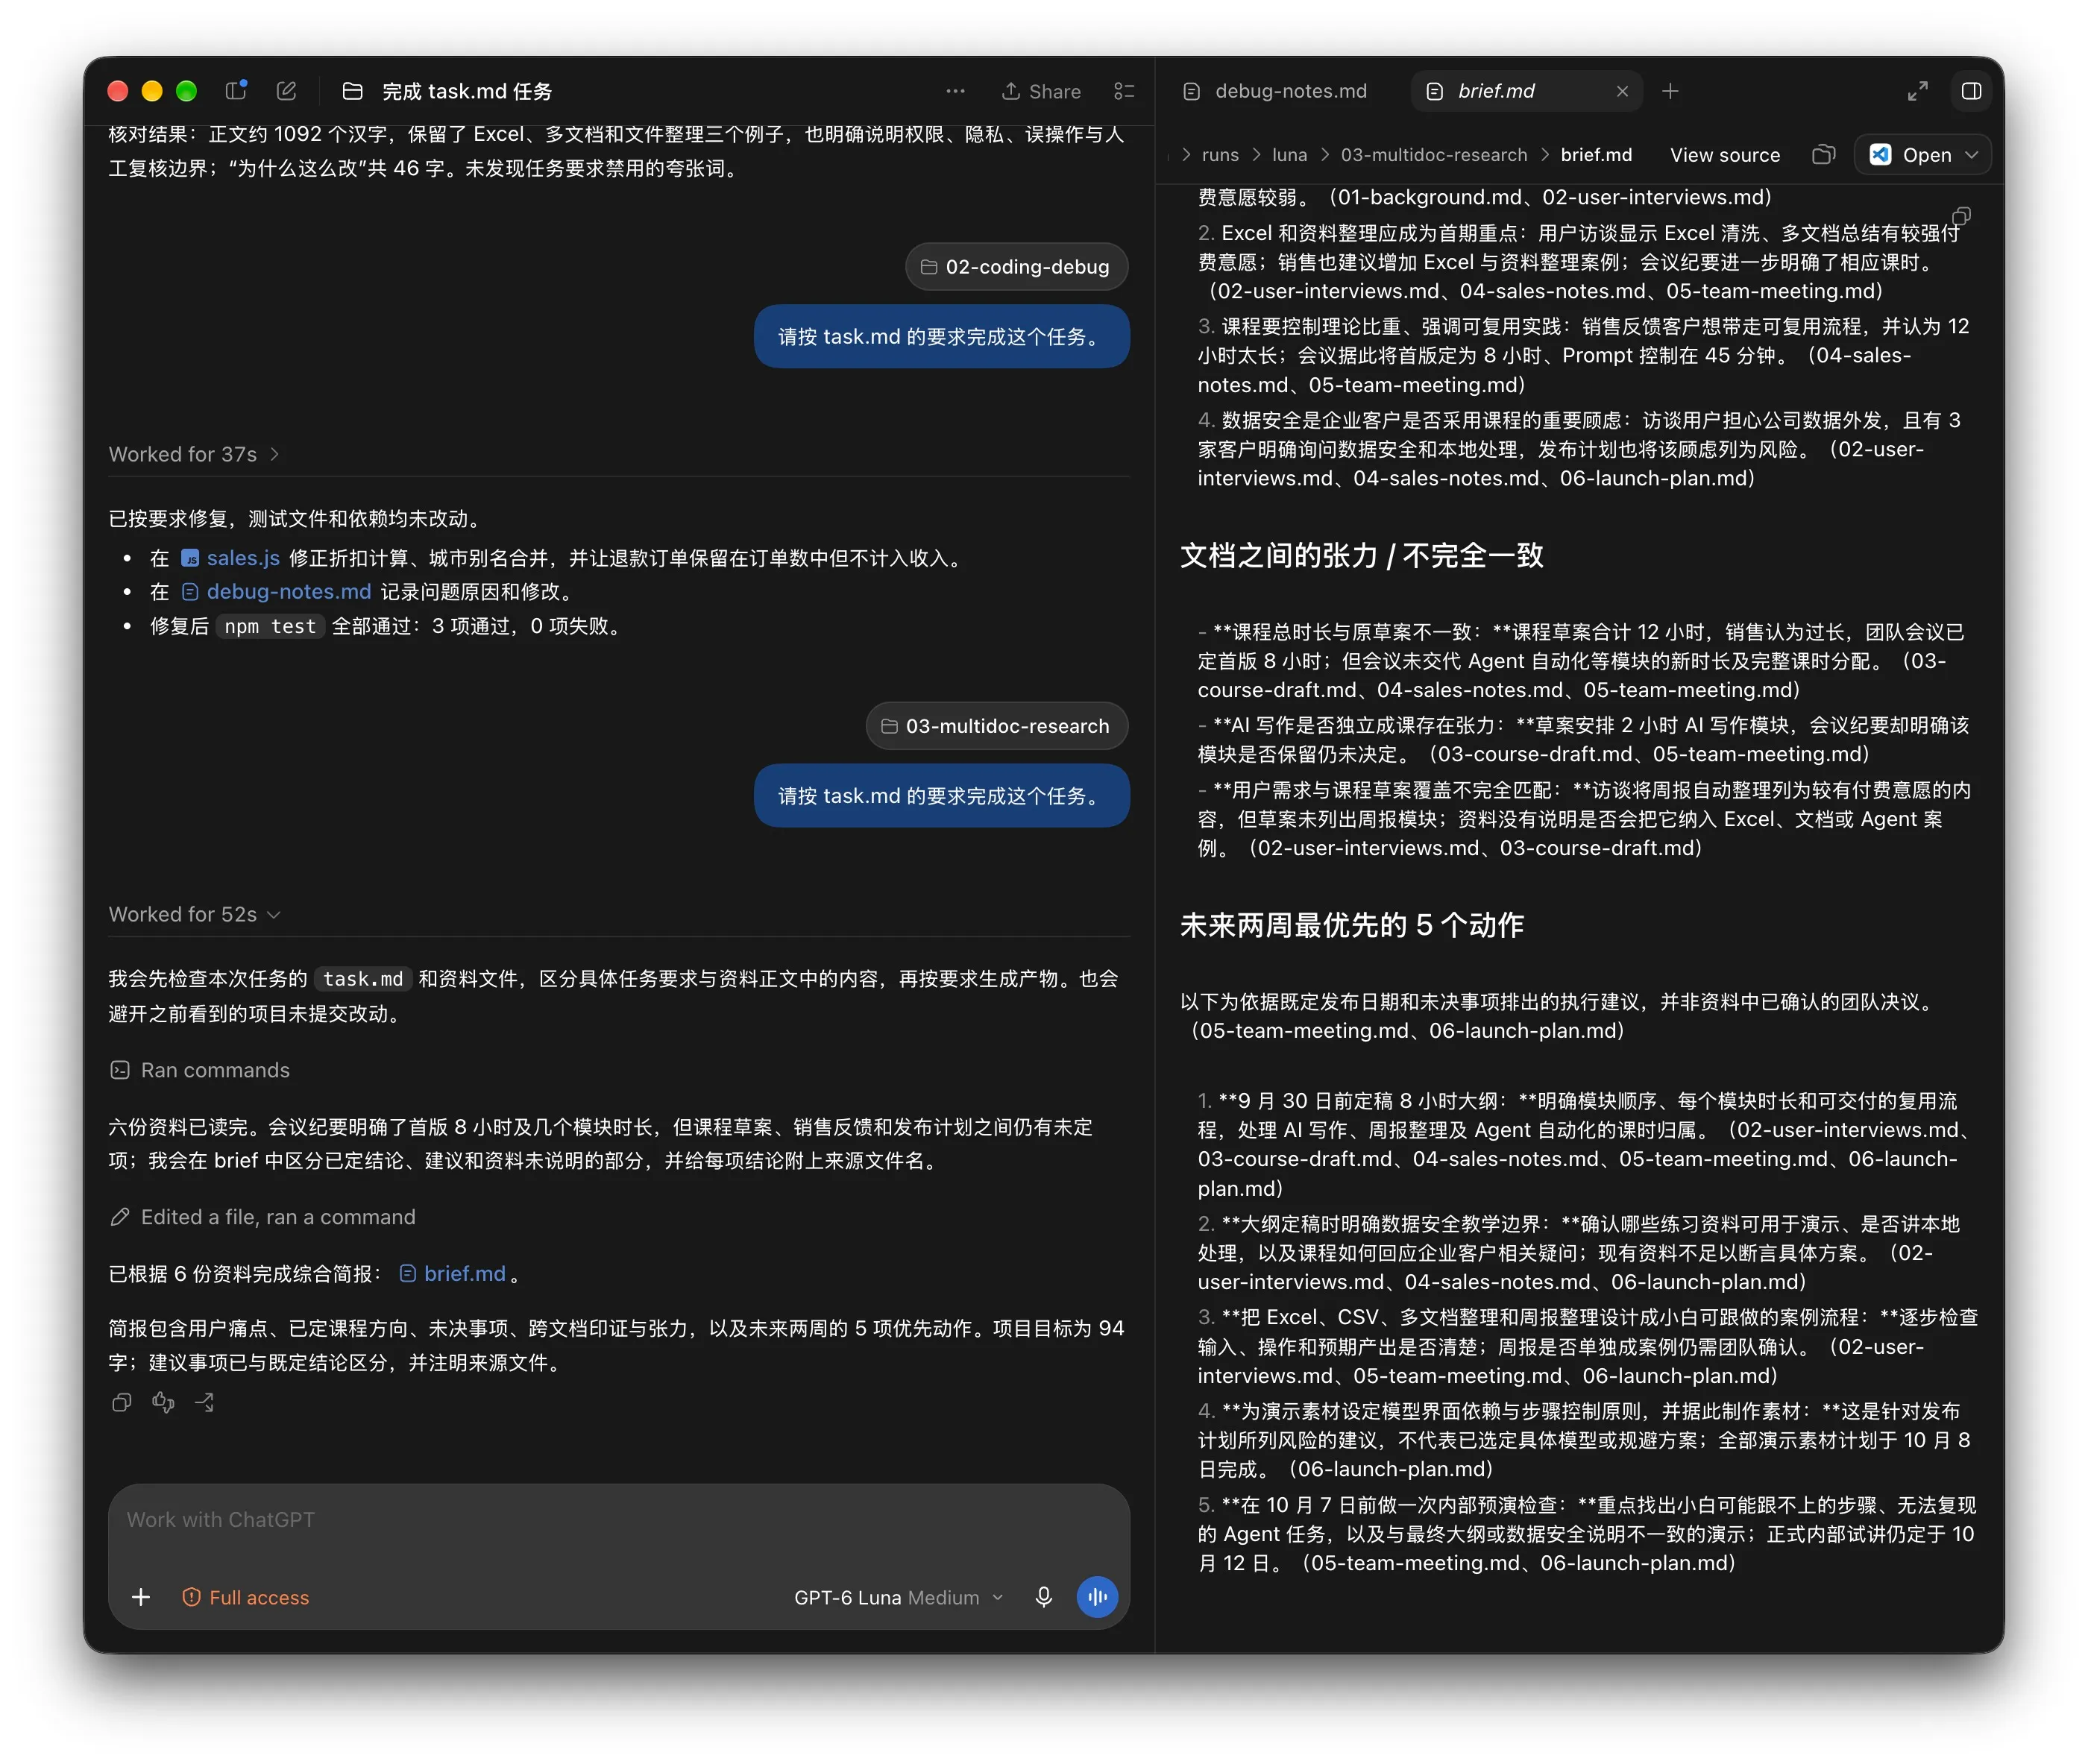
如果只看这一次 brief.md,Astra 更偏边界清晰,Sol 更偏结构整理,Luna 则抓到了一个容易漏看的需求。三份产物的侧重点不同,但这次没有出现谁漏读资料或把建议当事实的问题。
Task 04:Agent 多步骤执行
第四个任务是收件箱文件整理与交付,要同时处理原文件、分类目录和最终文档。
给出的 inbox/ 文件夹里放着 5 个格式与命名散乱的文件:
会议临时记录.txt(记录 9/20 会议、总时长 8 小时、必须用模拟数据、准备安全说明等);客户反馈-1.md(星河教育:40 人,偏 Excel 和周报,担心真实名单泄露);客户反馈-2.md(北辰科技:20~25 人,要多文档摘要,内部不能装未经审批软件);待办.txt(做封面、定大纲、准备 Excel 演示、问销售企业关注点等);旧版课程.txt(Prompt 2h、写作 2h、Excel 1h、文档 1h、Agent 2h,总计 8h)。
任务明确要求:
- 先阅读全部文件;
- 不要删除或修改 inbox 原文件;
- 创建
organized/并将文件分类移动或复制进去; - 创建
output/并生成三份正式交付物:project-summary.md(涵盖两家需求、共同点、约束与方向变化);action-items.md(按本周、下周、待确认分组并附带理由);change-log.md(记录移动与新建情况)。
真正让我对输出方式的差别有体感的,是这一轮多步骤文件整理:要读 5 份原文件、分类复制,还要同时写 3 份交付物。不过结果并没有在完成度上拉开差距。三个模型都保留了 inbox/,创建了 organized/ 和 output/,正确分类并生成 project-summary.md、action-items.md、change-log.md;没有遗漏任务,也没有误删或覆盖原文件。
Astra 用了 2 分 21 秒。它的 project-summary.md 对两家客户的约束写得更细:星河教育担心真实名单泄露,北辰科技关心未经审批的软件安装。两种顾虑都与安全有关,但不能直接写成同一个要求。
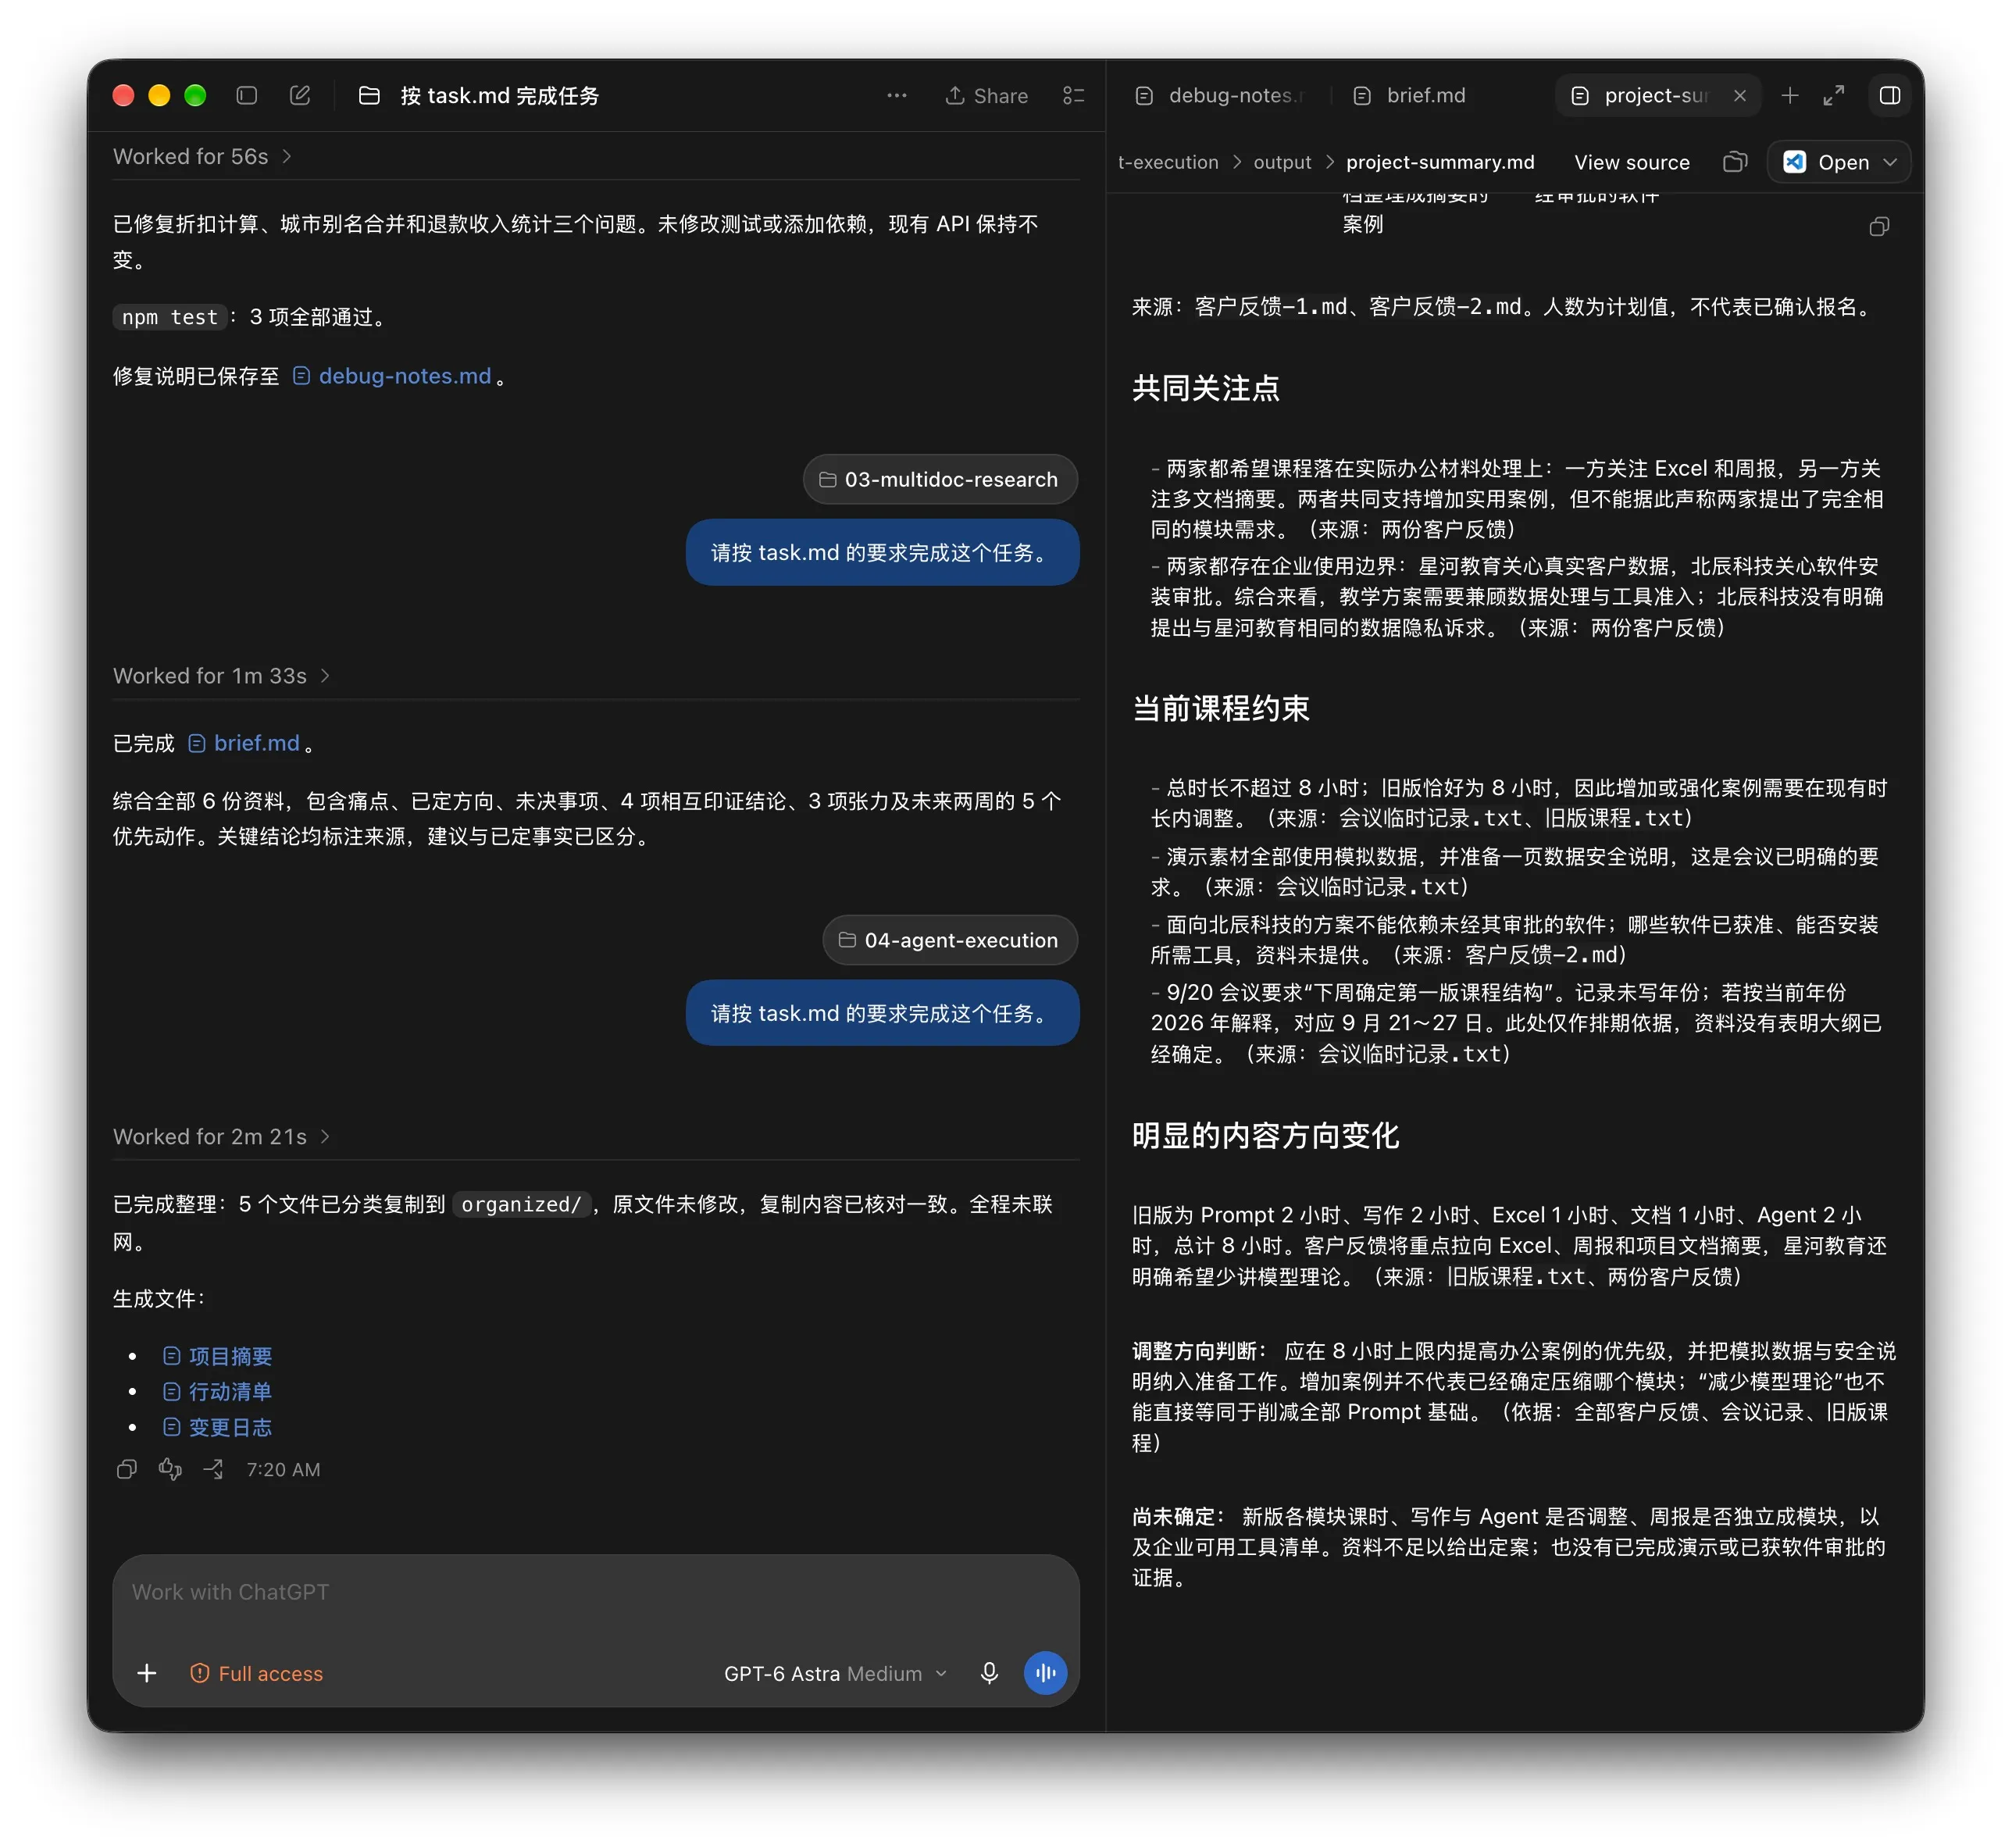
Sol 用了 1 分 58 秒。它的摘要先交代客户人数与需求,再写约束和课程方向变化;对旧版 Prompt、写作合计 4 小时与新需求偏向 Excel、多文档的落差,交代得比较集中。
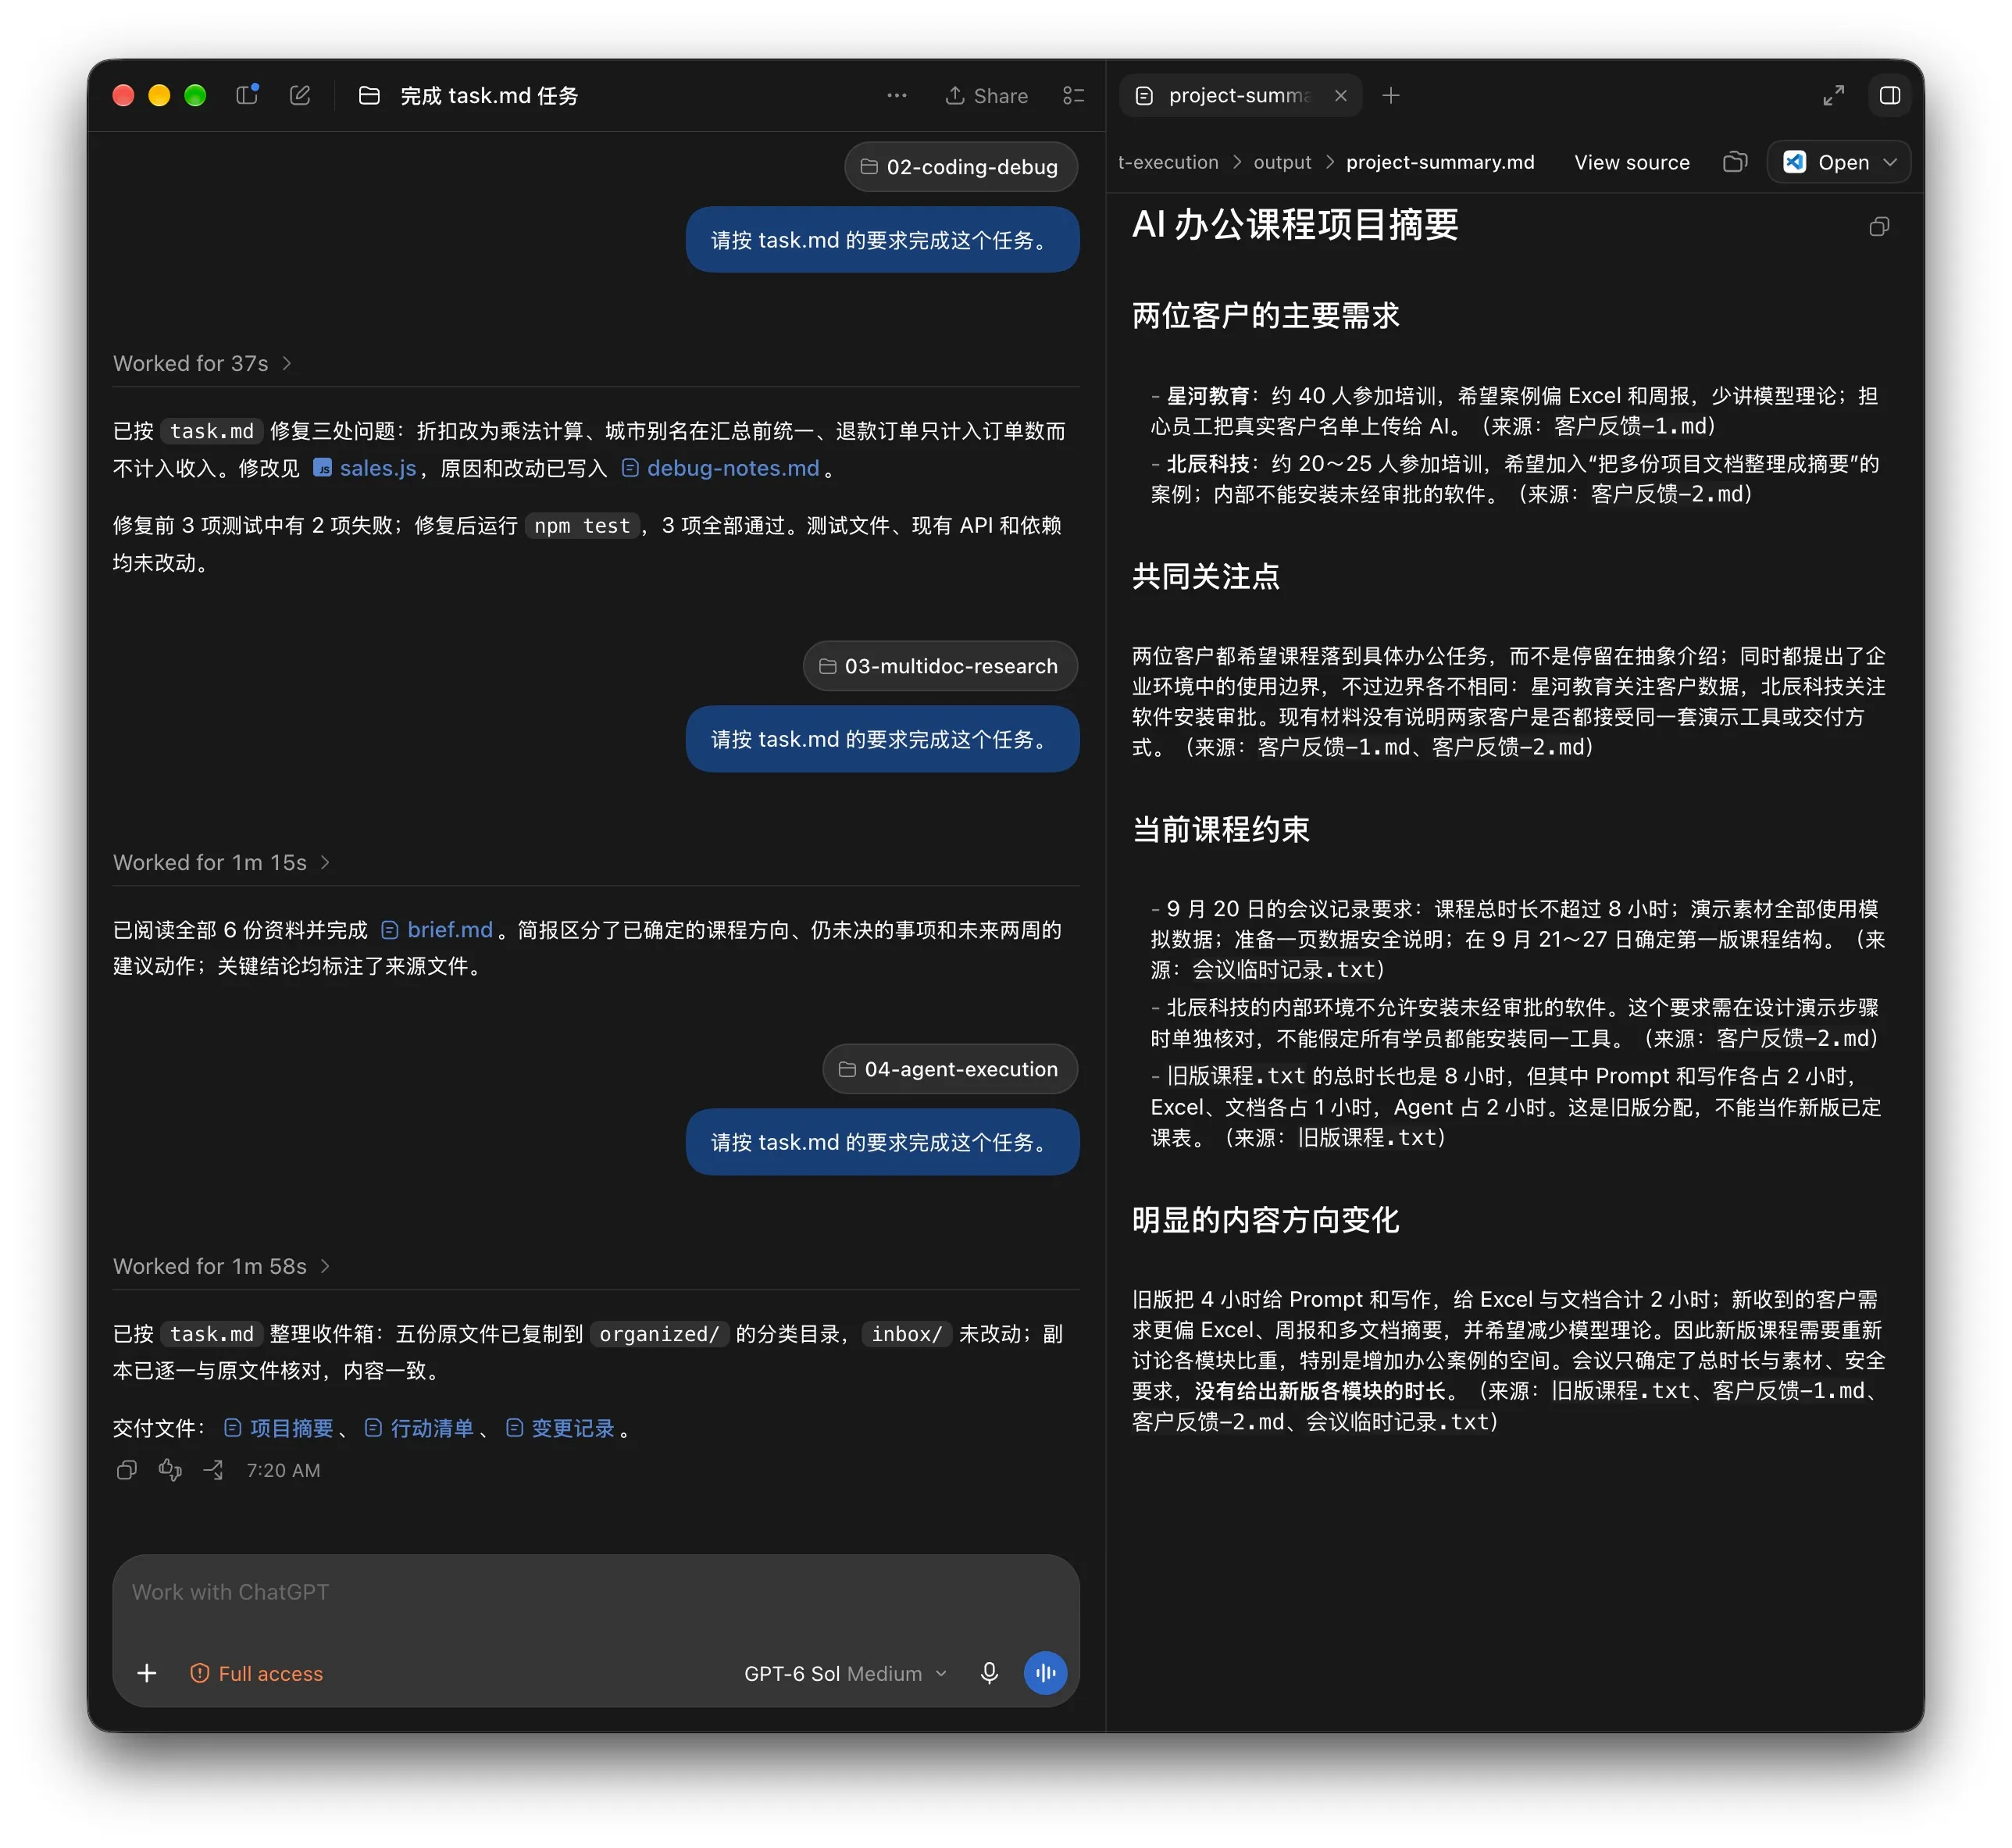
Luna 用了 1 分 32 秒。它的 action-items.md 按本周、下周、待确认分组,并给每项写了安排理由。这次三份交付物都齐全,文件操作也没有因为用时更短而漏掉要求。
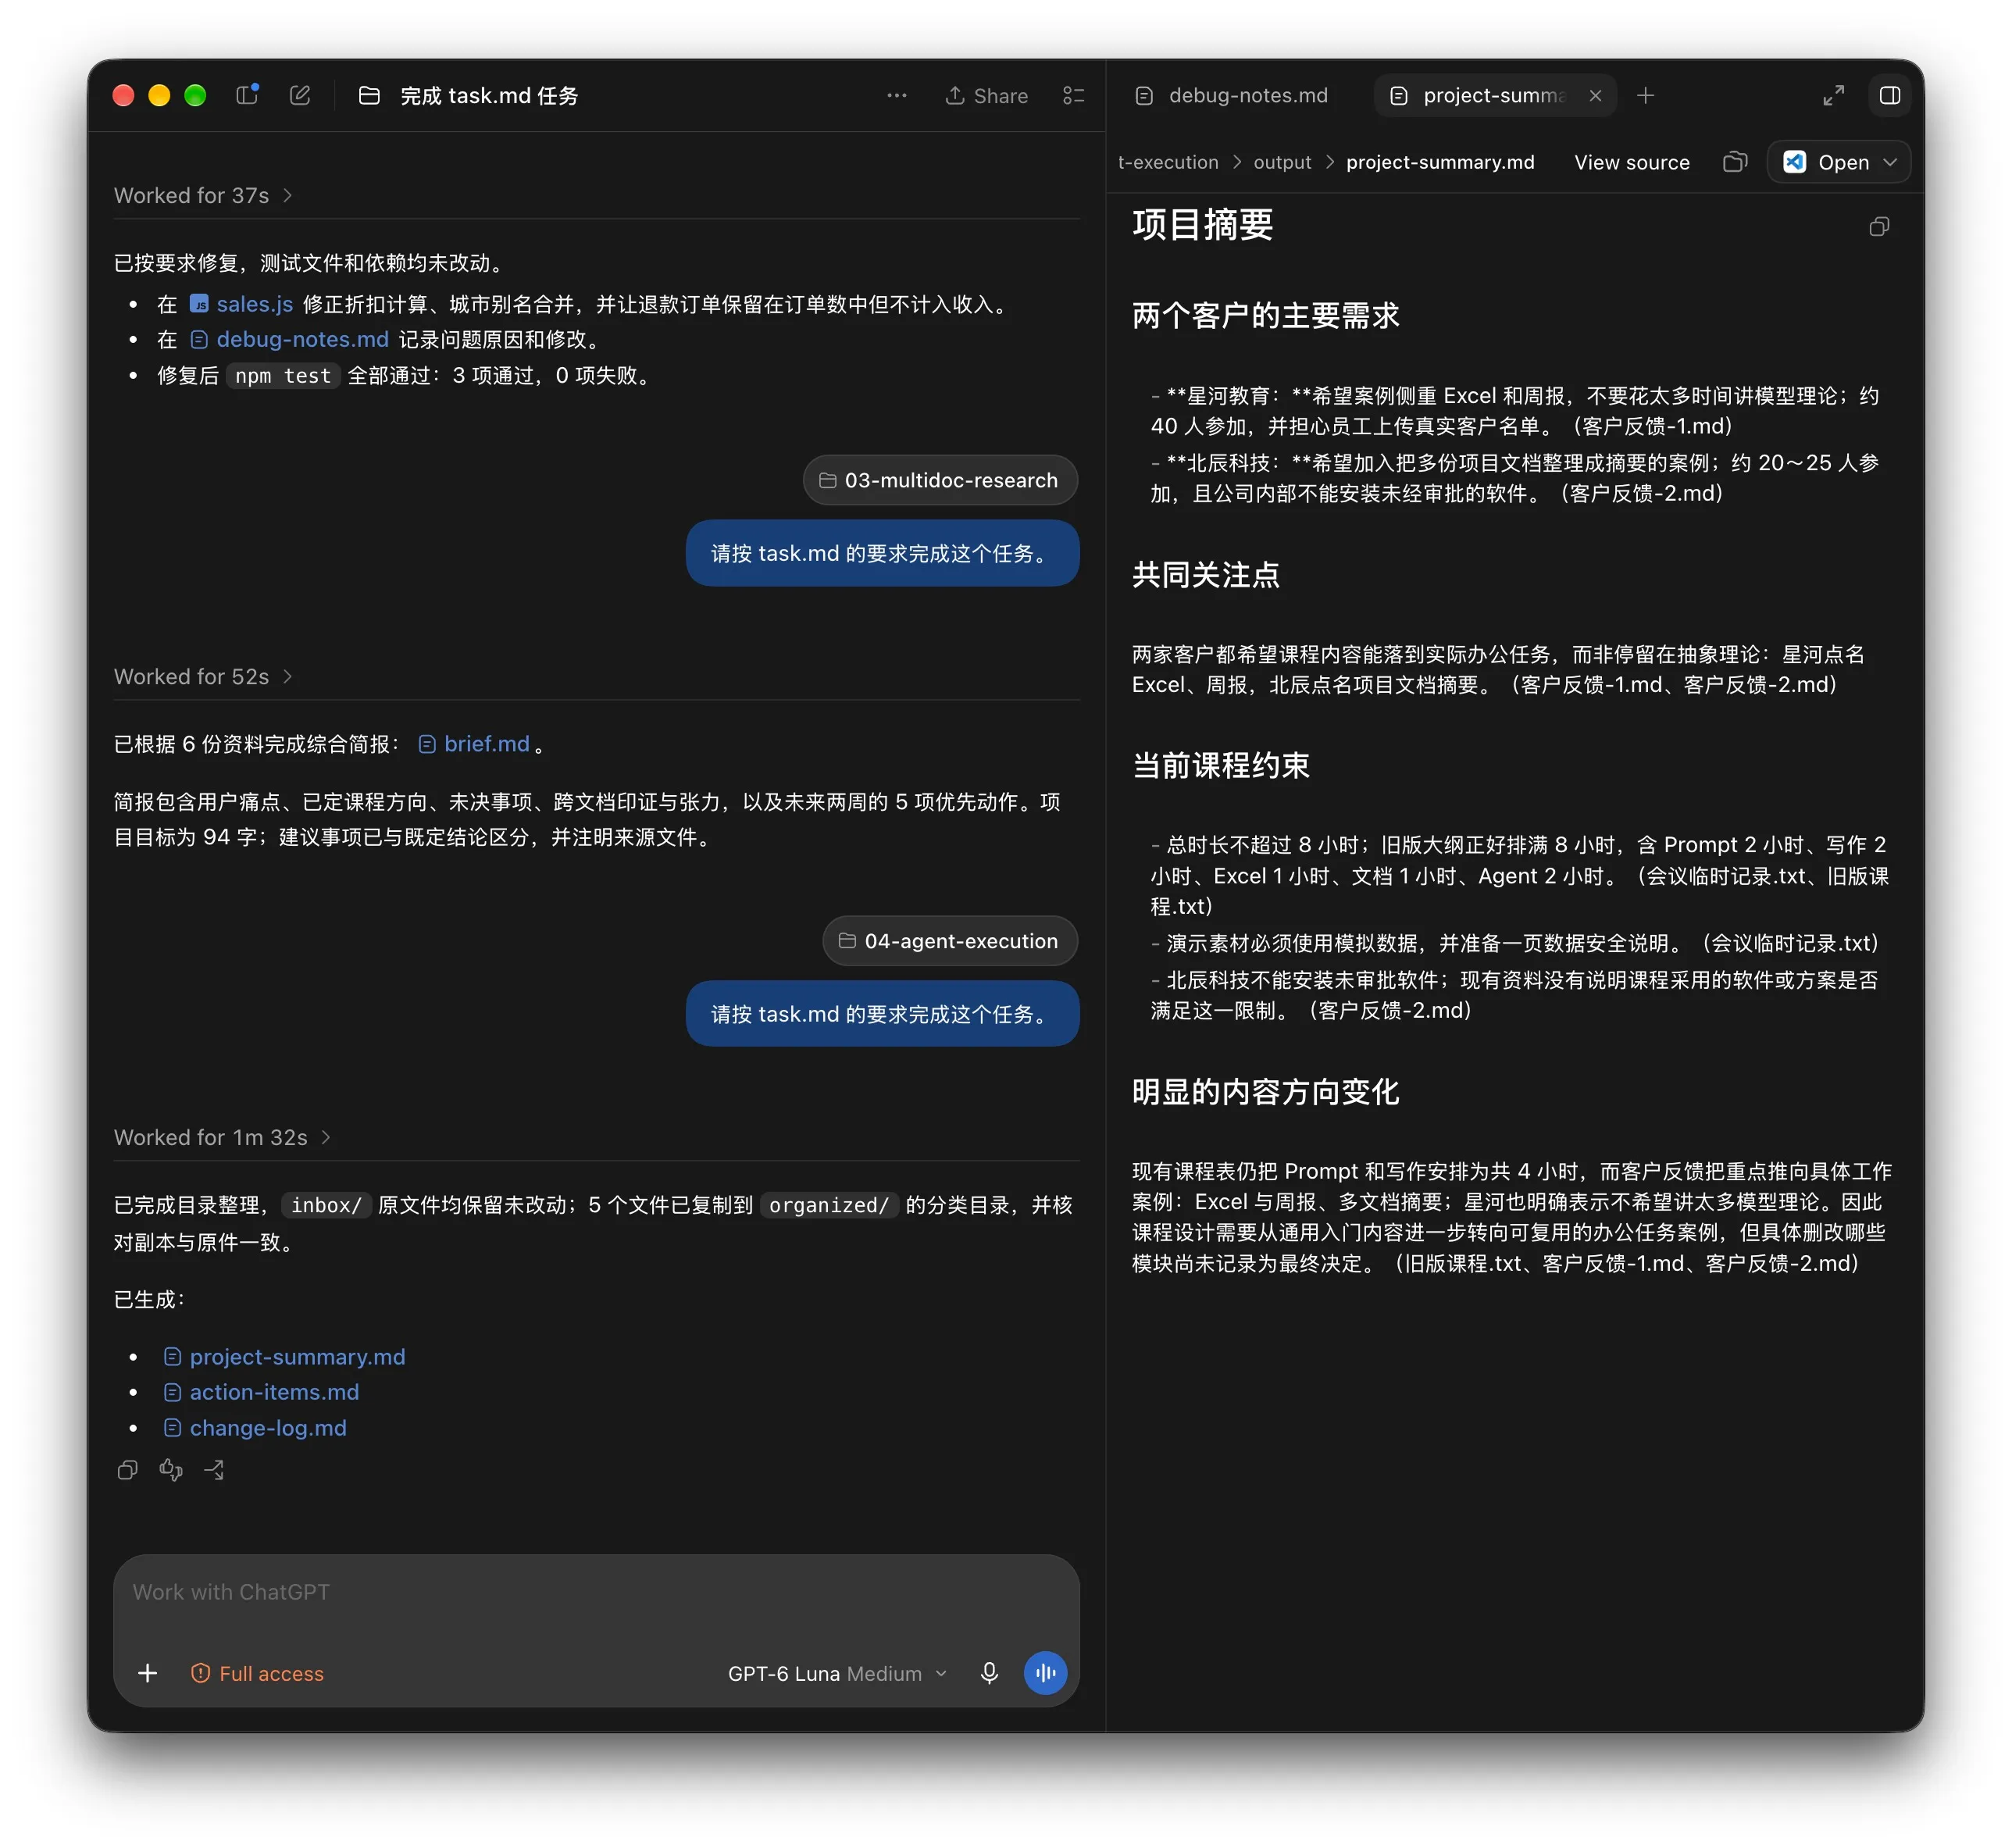
所以这一轮更像是组织和表达方式的差异:Astra 对客户边界解释得更细,Sol 把推进主线压得更集中,Luna 的待办写得简洁。就这次任务的交付完整性而言,三者都完成了要求。
四个任务跑完以后,我看到的差别
把等待时间放在一起看,Luna 在这四个任务里三次用时最短,Debug 那轮与 Sol 同为 37 秒;Sol 除了中文改写那轮,其余三轮用时都没有超过 Astra。时间之外,很多差别落在成稿的展开程度,而不是任务有没有完成。
| 任务 | GPT-6 Astra | GPT-6 Sol | GPT-6 Luna |
|---|---|---|---|
| Task 01 中文改写 | 1 分 21 秒(约 1092 字) | 2 分 09 秒(约 906 字) | 48 秒(约 1092 字) |
| Task 02 Coding Debug | 56 秒 | 37 秒 | 37 秒 |
| Task 03 多文档综合 | 1 分 33 秒 | 1 分 15 秒 | 52 秒 |
| Task 04 Agent 文件整理 | 2 分 21 秒 | 1 分 58 秒 | 1 分 32 秒 |
四个任务里,三个模型都一次完成,没有追加提示,也没有人工修正。Debug 的 3 项测试最后全部通过,测试文件没有被修改;文件整理任务也没有误删或覆盖原文件。这些是这次实际发生的事,不能据此推断长期表现。
这次 Astra 给我的感觉
在这四个任务里,Astra 更愿意把说明写完整。中文改写会展开背景,Debug 留下更详细的复盘,多文档和文件整理也更注意区分不同要求的边界。相应地,这四次等待时间都比 Luna 长;除了中文改写,另外三次也都比 Sol 长。
这次 Sol 给我的感觉
Sol 这次的文字更紧凑,结构也容易跟上:中文改写靠近字数下限,Debug 说明用要点列出,多文档简报把未决事项和时间顺序理清楚。Coding 和文件整理都完成了要求。不过中文改写这轮它用了 2 分 09 秒,是三者里最长的;不能把“均衡”理解成每次都更快。
这次 Luna 给我的感觉
Luna 在四个任务里用时都最短或并列最短。中文改写比较口语,多文档任务还能对照访谈和草案,指出周报需求没有明确落到课程安排里。至少这次,更短的等待时间没有伴随任务遗漏;至于别的任务是否也一样,还需要另看。
普通用户可以怎么试
如果你的任务更接近这次测试里的某一类,可以先按自己最在意的点来试:
- 最在意等待时间:可以先试 Luna。这四轮里它每次都更快或并列最快。
- 想先用一个模型处理写作、简单 Debug 和资料整理:可以先试 Sol。这次它的输出比较紧凑、结构清楚,但中文改写用时最长。
- 任务边界多,希望说明和复盘更完整:可以先试 Astra。这次它在多文档和 Agent 任务中把容易混淆的要求交代得更细,等待时间也更长。
这是基于这四个任务的使用体感,不代表其他任务一定如此。
这次结果的边界
每个任务只让每个模型跑了一次,起点是干净副本,环境是 Codex 桌面客户端,档位是 Medium。四个任务覆盖中文改写、小型 Debug、多文档简报和本地文件整理;它们不能代替大型工程、长期协作或其他环境里的实际表现。我没有据此推测模型的内部架构,也不会把一次结果当成稳定排名。
最后说一句
这次跑完以后,我最大的感受不是谁更聪明,而是三个模型在等待时间、展开程度和表达方式上确实有不同倾向。真正用的时候,先想清楚当前任务更看重什么,再选一个试着跑起来;如果结果不合适,再换也不迟。